信頼区間の解釈: 包括的なガイド
信頼区間を正確に解釈するための重要な洞察を学びます。
イントロダクション
信頼区間統計分析において非常に重要なツールです。標本データに基づいて、母集団パラメータが存在すると予想される範囲を示します。広く用いられているにもかかわらず、信頼区間しばしば誤解され、その解釈や意義について誤った認識が生じることがあります。
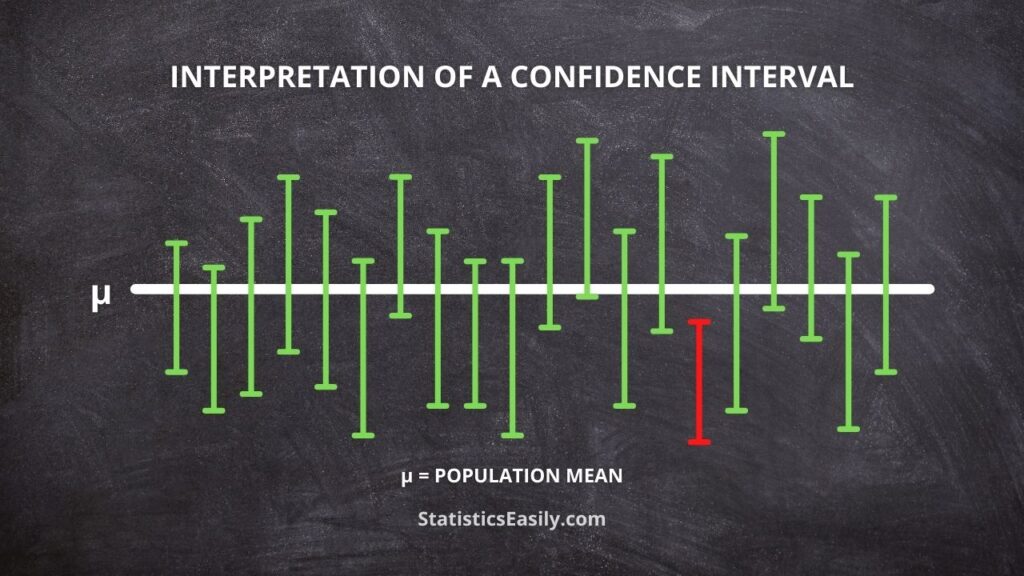
その中心において、the信頼区間を解釈する上で中心となるのは、絶対的な確実性ではなく、統計的な確実性という概念です。例えば、「95%の確信度」とは、繰り返しサンプリングを行った際に、パラメータが指定された区間内に収まる確率が95%であることを意味するのではなく、繰り返しサンプリングによって構築された区間の95%が真の母集団パラメータを包含することを意味します。
本稿では、こうした誤解をはじめとする様々な誤解を解消し、信頼区間どのように構築され、解釈され、様々な分野でどのように応用されているかについての理解を深めるための土台を築くことを目的としています。私たちの目標は、信頼区間の複雑さを分かりやすく解説し、読者が情報に基づいた正確な統計的推論を行うための本質を理解できるようにすることです。
ハイライト
- 95% の信頼水準は、繰り返されたサンプリングからのそのような間隔の 95% に真のパラメーターが含まれることを意味します。
- 信頼区間は、サンプルデータを点推定値 ± (臨界値 × 標準誤差) として使用して計算されます。
- 誤解には、95% 信頼区間をパラメータが含まれる確率が 95% であるとみなすことが含まれます。
- 医療における薬効などの実例は、信頼区間が重要な決定をどのように導くかを示しています。
- 間隔の境界を理解することは非常に重要です。それらは、妥当な範囲の値を表すものであり、その範囲内の確率分布を表すものではありません。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
信頼区間の基本
信頼区間(CI)は、標本データに基づいて母集団パラメータが存在する可能性のある範囲を推定するために用いられる基本的な統計ツールです。信頼区間を理解することは、医学から環境科学まで、さまざまな分野において研究結果を正確に解釈し、情報に基づいた意思決定を行う上で非常に重要です。
信頼区間とは何ですか?
A 信頼区間は、標本データから算出された、対象となる母集団パラメータが含まれる可能性が高い値の範囲を示すものです。この区間には信頼水準が関連付けられており、通常はパーセンテージ(例えば。:95%または99%)で表され、区間推定値の確実性の度合いを示します。
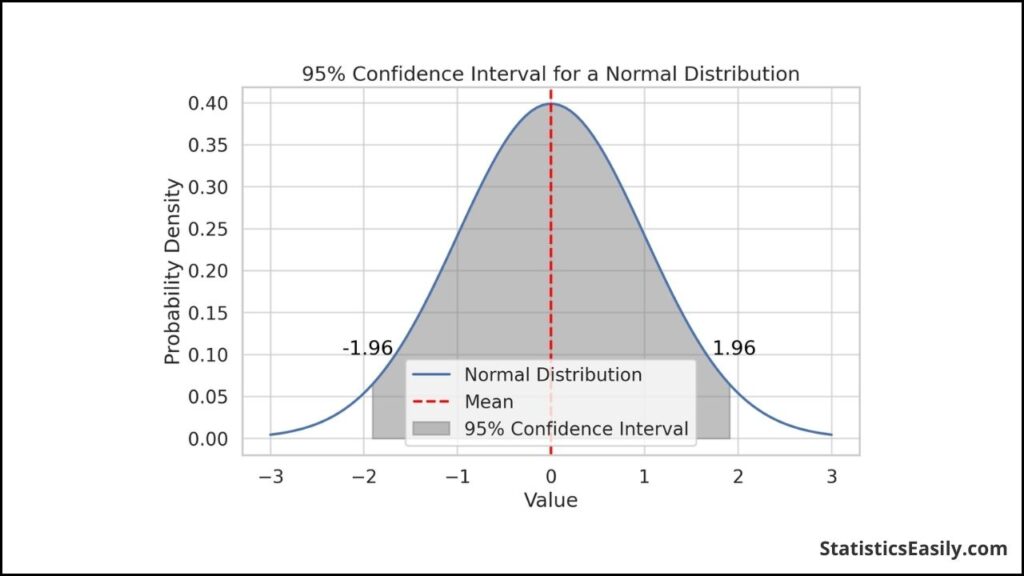
信頼区間の構築
の構築信頼区間の構築には、いくつかの手順が含まれます。
- サンプルデータの収集: 対象母集団からサンプルを収集します。
- 統計計算: 母集団パラメータの点推定値として標本統計量 (平均値、割合など) を計算します。
- エラー判定の余裕: 標本統計量の標準誤差と、必要な信頼水準に対応する z または t 分布からの臨界値を使用して誤差範囲を計算します。
- 間隔の計算: 標本統計量に誤差の範囲を加算および減算して、信頼区間の下限と上限を取得します。
の式信頼区間の計算式は一般的に以下の構造に従います。
CI = 点推定値 ± (臨界値 × 標準誤差)
信頼区間の背後にある統計理論
の理論的基盤は、信頼区間の理論的基礎は、確率論と中心極限定理にある。中心極限定理とは、標本サイズが十分に大きければ、母集団の分布に関わらず、標本平均の標本分布は正規分布に従うという定理である。
この統計理論は信頼区間の計算の基礎となり、統計学者や研究者がサンプル データに基づいて母集団パラメータについて確率的な推論を行うことができるようになります。
実際のアプリケーション
信頼区間平均値、割合、平均値間の差などのパラメータを推定するために、さまざまな分野で広く用いられています。例えば、臨床研究において、2つの治療群間の平均血圧の差に対する95%信頼区間は、治療効果と推定値の精度に関する知見を提供します。
信頼区間標本データに内在するばらつきを考慮した母集団パラメータの妥当な値の範囲を示すことで、点推定値よりも有益な情報を提供します。この範囲によって、研究者は研究結果の統計的有意性と実用的な妥当性を評価することができます。
信頼区間を正しく解釈する
の正しい解釈信頼区間の正しい解釈は、正確な統計分析と情報に基づいた意思決定にとって極めて重要です。本節では、統計実務で一般的に用いられる95%信頼水準に焦点を当て、信頼区間の適切な理解について解説します。
95% の信頼水準を理解する
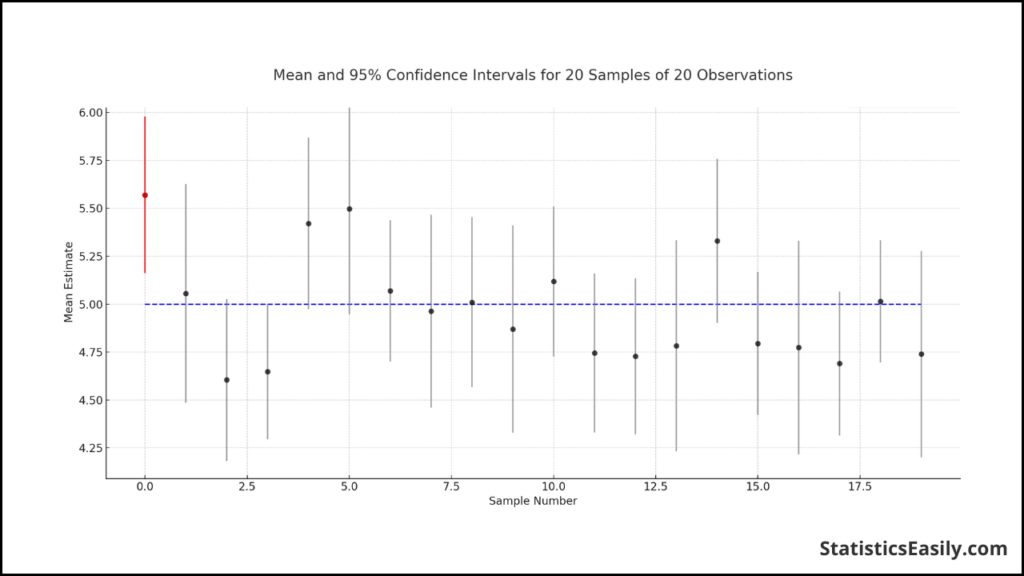
A 95% 信頼区間は、100個の異なるサンプルを抽出し、それぞれについて信頼区間を構築した場合、そのうち約95個の区間に真の母集団パラメータが含まれると予想されることを示唆しています。この解釈は、信頼区間が確率的な性質を持つことを強調しています。つまり、信頼区間は、特定のサンプルから得られたパラメータが特定の区間内に含まれる確率を示すものではないということです。
上限と下限の重要性
- 下界: これにより間隔が開始され、指定された信頼水準で母集団パラメータが見つかる可能性が高い最低値が示されます。
- 上界: 逆に、これは間隔の終わりであり、母集団パラメータを含むと予想される最高値をマークします。
これらの境界は、サンプル データに基づいてパラメータの妥当な値の範囲を示します。真の母集団パラメータは固定されており、パラメータが区間内で「移動」するのではなく、区間が一定の信頼度でこのパラメータを「捕捉」することを理解することが重要です。
母集団パラメータのコンテキスト化
母集団パラメータのコンテキストでは、信頼区間の境界により、パラメータの潜在的な変動性についての洞察が得られます。たとえば、サンプルに基づいて母集団の平均身長を推定する場合、95% 信頼区間 [160 cm, 170 cm] は、サンプル データに基づいて、母集団全体の真の平均身長を 95% 信頼できることを示します。人口はこれら XNUMX つの値の間に収まります。
正しい解釈のための重要なポイント
- 信頼水準: これは、異なるサンプルから同じ方法で構築された区間が真の母集団パラメーターを包含する頻度を表します。
- 間隔の境界: これらは、パラメータが極値にある可能性に関するものではなく、パラメータをカバーする範囲に関するものです。
- 固定パラメータ: 母集団パラメータは固定量であり、信頼区間は、この固定値が存在するサンプルに基づく範囲を提供します。
これらの側面を理解することは、信頼区間を正確に解釈し、よくある誤解を回避し、統計結果を現実のシナリオに効果的に適用するために不可欠です。
よくある誤解とその回避方法
周囲の誤解信頼区間に関する誤解は、誤った結論や統計データの誤用につながる可能性があります。これらのよくある落とし穴を認識し、回避することは、正確なデータ解釈のために不可欠です。
誤解 1: 封じ込めの確率としての信頼水準
よくある誤解として、95%信頼区間、その区間が真の母集団パラメータを含む確率が95%であることを意味すると解釈してしまうケースがあります。しかし、この解釈は誤りです。なぜなら、信頼区間はパラメータを含むか含まないかのどちらかであり、95%信頼水準は、同じ研究を何度も繰り返した場合に、そのような区間がパラメータを含む長期的な割合を示すものだからです。
回避方法:信頼水準とは、多数のサンプルにおける方法の信頼性を指し、単一の区間にパラメータが含まれる確率を指すものではないことを理解してください。
誤解 2: パラメータは区間全体に均等に存在します
もう一つよくある間違いは、母集団パラメータが信頼区間内のどこにでも等しい確率で存在すると仮定することです。信頼区間妥当な値の範囲を示しますが、パラメータが区間の両端よりも中央付近に存在する可能性が高いことを示唆するものではありません。
回避方法:区間は、パラメータの妥当な値の範囲を示しているだけで、その範囲内の尤度分布は指定されていないことを認識する。
誤解 3: 間隔が狭いほど精度が高いことを示す
間隔が狭いほど、より正確または正確であると誤解されることがよくあります。ただし、狭い間隔はサンプル サイズが小さいか信頼水準が高いために生じる可能性があり、これは必ずしも真の母集団パラメーターに関する精度や精度が向上することを意味するわけではありません。
回避方法: 解釈する際には、サンプルサイズと信頼水準を含む文脈を評価する信頼区間.
誤解4: 重複する区間と統計的有意性
の重なり信頼区間が重なっている場合、グループ間に有意差がないと誤解されることがあります。重なりはより詳細な検討が必要であることを示唆する可能性はありますが、それだけで統計的有意性を判断するものではありません。
回避方法:適切な仮説検定と信頼区間を用いて、グループ間の統計的有意性を評価する。
誤解 5: 予測目的の信頼区間
信頼区間を使用して将来の観測値を予測することは、概念の誤用です。信頼区間は、将来の個々の観測値の範囲ではなく、母集団パラメータを推定します。
回避方法:母集団パラメータの推定と個々の結果の予測を区別し、後者には予測区間を使用する。
信頼区間の解釈の実践例
実用的な例は、信頼区間という抽象的な概念を分かりやすく説明する上で非常に有効な手段です。本節では、医学、環境科学、経済学といった分野から詳細な事例を取り上げ、それぞれの例における信頼区間の計算方法、解釈、そしてその意味するところを解説します。
例 1: 医学 - 新薬の有効性
ある製薬会社は、新薬の有効性を標準治療と比較する臨床試験を実施しました。主要エンドポイントは、12週間の治療後の収縮期血圧の変化でした。
- データ: 15 人の患者のサンプルに基づくと、新薬による収縮期血圧の平均変化は -10 mmHg、標準偏差は 100 mmHg でした。
- 計算: 収縮期血圧の平均変化の 95% 信頼区間は、-15 mmHg ± 1.96 × (10 mmHg / √100) として計算され、[-17, -13] mmHg となります。
- 解釈: 私たちは、新薬で治療された集団の収縮期血圧の真の平均変化が -95 ~ -17 mmHg の間にあることを 13% 確信しています。
- 含意: 間隔には 0 が含まれておらず、薬剤が血圧降下に対して統計的に有意な効果があることを示唆しています。
例 2: 環境科学 – 大気質の改善
環境当局は、新しい公共交通政策の導入後の都市の大気質の改善を監視しました。
- データ: 2.5 年間にわたる毎月のサンプルに基づくと、粒子状物質 (PM5) の平均減少量は 2 μg/mXNUMX で、標準偏差は XNUMX μg/mXNUMX でした。
- 計算: PM95 の平均減少量の 2.5% 信頼区間は、5 μg/m1.96 ± 2 × (12 μg/m4.07 / √5.93) として計算され、[XNUMX, XNUMX] μg/mXNUMX となります。
- 解釈: この政策による PM95 の真の平均削減量は 2.5 ~ 4.07 µg/m5.93 であると XNUMX% 確信しています。
- 含意: この間隔は生産性が大幅に向上していることを示しており、トレーニング プログラムへの投資が正当化されます。
例 3: 経済学 – 従業員の生産性に対するトレーニングの影響
ある企業は、従業員の生産性に対する新しいトレーニング プログラムの影響を、時間当たりの生産単位数で測定して評価しました。
- データ: 従業員 3 人のサンプルに基づくと、トレーニング後の生産性の平均向上は 1.5 単位/時間、標準偏差は 50 単位/時間でした。
- 計算: 95%信頼区間生産性の平均増加量は 3 単位/時間 ± 1.96 × (1.5 単位/時間 / √50) として計算され、[2.32, 3.68] 単位/時間となります。
- 解釈: トレーニング後の全従業員の真の平均生産性向上は 95 ~ 2.32 単位/時間であると 3.68% 確信しています。
- 含意: この間隔は生産性が大幅に向上していることを示しており、トレーニング プログラムへの投資が正当化されます。
信頼区間の高度な概念
このセクションでは、 ノンパラメトリック 信頼区間、ベイズ信頼区間、そしてサンプルサイズと分散が信頼区間に及ぼす微妙な影響について解説します。これらの高度な概念は、複雑な分析シナリオにおける信頼区間の理解を深め、解釈力と信頼性を向上させます。
ノンパラメトリック信頼区間
従来の CI は、特にサンプル サイズが小さい場合に、データが正規分布に従うという仮定に依存することが多く、中心極限定理がこの近似に役立ちます。ただし、現実世界のデータはこの仮定から大きく逸脱する可能性があるため、ノンパラメトリック手法が必要になります。ブートストラップ法から派生したものなどのノンパラメトリック CI は、特定のデータ分布を想定しないため、幅広いデータ型に対して多用途かつ堅牢になります。この柔軟性により、非正規分布または未知の分布においてより正確な区間推定が可能になりますが、多くの場合、計算の複雑さは増大します。
ベイズの信頼区間
ベイズ信頼区間(または信用区間)は、事前知識や信念を区間推定プロセスに組み込みます。サンプリングされたデータのみから信頼区間を解釈する頻度論的アプローチとは異なり、ベイズ信頼区間は、このデータと事前分布を組み合わせて、対象となるパラメータの事後分布を形成します。このアプローチは、 不確実性 推定のためのより包括的な枠組みを提供し、特に医学や政策分析など、過去の研究や専門知識が現在の知見の解釈に重要な役割を果たす分野で有益です。
サンプルサイズと分散の影響
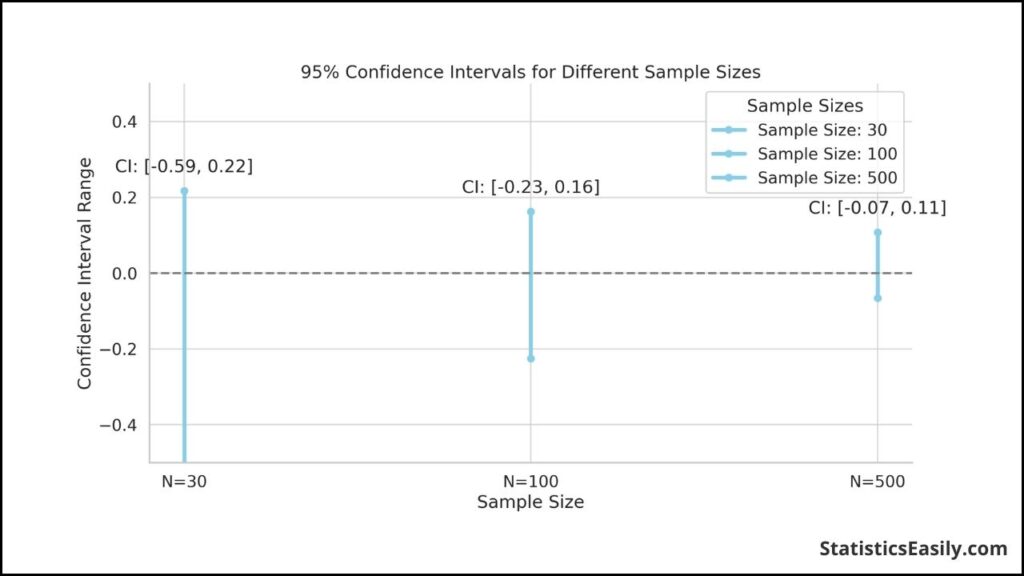
信頼性と信頼区間の幅は、サンプルサイズとデータの分散によって直接影響されます。サンプルが大きくなると間隔が狭くなる傾向があり、これはパラメーター推定値に関する不確実性の減少を反映しています。逆に、データ内の分散が大きいと間隔が広くなり、不確実性が大きくなることを示します。これらの関係を理解することは、サンプルサイズ、データの変動性、区間推定の精度の間のトレードオフを浮き彫りにするため、研究の設計とCIの解釈にとって非常に重要です。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
結論
この包括的なガイド全体で信頼区間の解釈ガイドでは、統計分析と情報に基づいた意思決定における信頼区間の重要な役割を強調する、基礎概念、実践的な応用、よくある誤解、そして現実世界の例について解説してきました。
重要なポイント
- 信頼区間サンプルデータから導出された母集団パラメータの妥当な値の範囲を、確実性の程度を示す関連する信頼レベルとともに提供します。
- 正しく解釈するには、95% の信頼水準は、パラメーターが区間内に収まる確率が 95% であることを意味するものではないことを理解する必要があります。代わりに、プロセスが多くのサンプルにわたって繰り返される場合、そのような間隔の 95% に真のパラメーターが含まれます。
- 信頼区間の解釈を誤ると、統計結果の理解と応用が大きく歪む可能性があります。区間境界の微妙な違いと母集団パラメータの固定的な性質を理解し、よくある落とし穴を避けることが重要です。
- 医学、環境科学、経済学の例では、信頼区間の計算、解釈、意味を説明し、さまざまな分野にわたる信頼区間の多用途性と重要性を示しました。
の正しい解釈信頼区間の正しい解釈は、単なる学術的な演習ではなく、信頼性の高い科学研究を実施し、データに基づいて的確な意思決定を行うための根本的な要素です。統計分析に取り組む際には、信頼区間の理解と適用に常に注意を払い、科学的に正確かつ有意義な結論を導き出すようにしましょう。
統計のベスト プラクティスに対するより深い理解と認識を促進するために、読者がさらなるリソースを探索し、分析スキルを向上させるために統計の概念に取り組み続けることをお勧めします。
おすすめ記事
関連する統計トピックに関する記事のコレクションを利用して、より多くの洞察を調べ、理解を深めてください。今すぐ飛び込んでください!
よくある質問(FAQ)
Q1:信頼区間とは具体的に何ですか?信頼区間とは、標本データに基づいて、ある程度の信頼度で真の母集団パラメータが存在すると予想される範囲を示すものです。
Q2:95%信頼区間とは何ですか?95%信頼区間とは、サンプリングプロセスを何度も繰り返した場合、作成された区間の約95%が真の母集団パラメータを含むことを意味します。
Q3:統計学において信頼区間が重要な理由は何ですか?信頼区間を用いることで、パラメータ推定値の不確実性を推定することができ、単一の推定値だけでなく、妥当な値の範囲を示すことができるため、統計的結論の信頼性が向上します。
Q4:信頼水準と信頼区間の違いは何ですか?信頼水準は、実験を繰り返した場合に信頼区間に真のパラメータが含まれる頻度を示しますが、信頼区間自体は真のパラメータが含まれる可能性が高い値の範囲です。
Q5:信頼区間は予測に使用できますか?信頼区間は母集団パラメータを推定するために設計されており、個々の将来の観測値を予測するために設計されているわけではありません。
Q6:サンプルサイズと分散は信頼区間にどのように影響しますか?サンプルサイズが大きいほど、また分散が小さいほど、信頼区間は狭くなり、母集団パラメータの推定精度が高くなります。
Q7:どのような誤解を避けるべきですか?よくある間違いとしては、信頼水準を区間内にパラメータが含まれる確率と混同することや、パラメータが区間内のどこにでも等しい確率で存在すると仮定することなどが挙げられます。
Q8:信頼区間はどのような実世界の応用分野で使用されていますか?医学分野では薬の有効性を評価するために、環境科学分野では大気質の改善を研究するために、経済学分野では研修プログラムが生産性に与える影響を評価するために利用されています。
Q9:上限と下限は何を表していますか?信頼区間の境界は、指定された信頼水準で真の母集団パラメータが見つかる可能性が高い範囲を表します。
Q10:ノンパラメトリック信頼区間とベイズ信頼区間の違いは何ですか?ノンパラメトリック信頼区間は、データの分布に関する仮定に依存しません。一方、ベイズ信頼区間は、計算プロセスに事前知識や信念を取り入れます。