対応のある T 検定: 包括的なガイド
科学的誠実性とデータ分析の精度を高める上での対応のある t 検定の極めて重要な役割を学びます。
イントロダクション
The 対応のあるt検定は、異なる条件下で同一被験者から得られた2組の観測値を比較することで、介入の効果を判定するために用いられる、精度の高い統計的手法です。研究におけるその重要性は非常に高く、治療効果、教育プログラムの影響などに関する洞察を提供します。
機能的な応用を超えて、 対応のあるt検定は 科学的方法の証であり、発見が単なる偶然ではなく現実を反映していることを保証する。それは、経験的真実の崇高な探求における分析上の味方であり、研究者が自信を持って結論を導き出し、自然界に内在する秩序と調和を明らかにすることを目指す科学的知見の蓄積に貢献することを可能にする。
統計分析において、対応のあるt検定、新薬の有効性、学生の成績向上、あるいは「前後」が重要なあらゆるシナリオについて、データの流れを繋ぎ合わせて一貫性のあるストーリーを構築する手段となり得る。
個人差を制御することで、変化を観察し、定量化し、検証するための焦点を絞ったレンズが提供され、大きな進歩への道が開かれます。
このガイドでは、 paired サンプル t検定の理論的基礎から実践的な応用まで、その複雑な仕組みを探求し、数値的な理解にとどまらず、倫理的かつ影響力のある研究の領域にまで及ぶ包括的な理解を目指します。
ハイライト
- 感度の向上:ペアリングされた サンプル t 検定は測定値間の変動性を独自に低減し、統計分析の感度と精度を高めます。
- 前提の明確化: 正確な適用に不可欠な対応のある t 検定では、対応のある観測値間の差が正規分布していると仮定し、信頼性を支えています。
- 多様な用途: ケーススタディでは、その有用性が医学などの複数の分野に及ぶことが実証されており、治療効果の評価におけるテストの役割が示されています。
- ガイド付き実行: R などの統計ソフトウェアで対応のある t 検定を実行するための包括的なガイダンス。方法論の健全性とデータの整合性を保証します。
- 落とし穴を避ける: このセクションでは、対応のある t 検定を実施および解釈する際によくあるエラーを回避するための実用的なヒントを提供し、堅牢で倫理的な統計手法を促進します。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
対応のあるT検定の理論的背景
The 対応のあるt検定各被験者がコントロールできるという前提に基づいており、これが理論的根拠の基礎となっています。この検定では、対応する2つのサンプルの平均差を分析することで比較を行い、ペア間の差が正規分布に従うと仮定します。つまり、観測値のペア間の平均差が統計的にゼロと異なるかどうか、つまり効果や変化がないかどうかを評価するものです。
の仮定対応のあるt検定の妥当性を確保するためには、その前提条件が非常に重要です。これらの前提条件には、ペア内の差が同一の分布に従い、かつペア間で独立しているという仮定が含まれます。これらの差は、未知ではあるものの等しい分散を持つ正規分布母集団から導出されます。このような前提条件は単なる技術的な問題ではなく、検定結果の信頼性を保証する枠組みなのです。
ペア比較を検討する際、統計的対称性の美しさを実感できるでしょう。 対応のあるt検定 ペアになった観測値間の本質的な関連性を活用し、測定対象の真の効果を覆い隠してしまう可能性のある変動性を効果的に制御します。ペアt検定は、各ペア内の差異に焦点を当てることで、 paired サンプル t検定 交絡変数の影響を軽減し、効果のより正確な測定を可能にします。
ペア差の概念は、様々な応用分野において基本となるものであり、例えば、新しい治療法の効果を治療前後の患者の転帰を比較することで評価する医学研究などが挙げられます。このような比較は、 対応のあるt検定 目指すバランスと対称性を体現しており、観察された効果が治療によるものであり、外部要因によるものではないことを保証します。
対応のあるT検定の実用的応用
The 対応のあるt検定、様々な科学分野で重要な分析手法であり、研究におけるその適応性と重要性を示しています。医学分野では、治療前後の患者の健康指標を比較することで、新しい治療法の有効性を分析するためによく用いられます。この検定では、各患者を対照群として対応させることができるため、個人差に起因するばらつきを最小限に抑え、治療効果をより明確に把握することができます。
The paired サンプル t検定 が用いられます。例えば、認知行動療法が治療前後の不安レベルに及ぼす効果を評価する際にこの方法を用いることで、介入による真の心理的効果を明らかにすることができます。
教育研究においても、対応のあるt検定有効である。この検定を用いることで、特定の教授法を実施する前後の生徒の成績を比較し、教育戦略の効果を測定することができる。この方法により、教育者は実証的な証拠に基づいて自身の教授法を批判的に評価し、改善することが可能となる。
対応のある T 検定を実行するためのステップバイステップ ガイド
実行する 対応のあるt検定 を実行するには、対応のあるデータの収集から始まり、統計結果の解釈に至るまで、一連の体系的な手順が必要です。ここでは、データの整合性と正確な表現に重点を置き、 paired サンプル t検定 実行するための構造化されたガイドを示します。 Rを使用して対応の
1. データの収集と準備
同じ個人に対する医療介入の前後の血圧測定値など、関連する 2 セットの測定値からペア データを収集します。データがクリーンで、一致しており、結果を歪める可能性のある外れ値がないことを確認します。
2. Rでの実行
- データをRに読み込み、2つの列に構造化して、'前に'と'後'条件、各行は一致するペアに対応します。
- 使用する‘t.test()’関数は対応のあるt検定を実行します。コマンドの例は次のようになります。't.test(前、後、ペア = TRUE)', where '前に'と'後'データ ベクトルです。
- 出力には、結果を解釈するために不可欠な t 統計量と p 値が含まれます。
# Paired t-test in R
# Assuming 'before' and 'after' are your vectors of paired observations

# Perform the paired t-test
t_test_results <- t.test(before, after, paired = TRUE)

# Output the results of the paired t-test
print(t_test_results)

# Calculate Cohen's d for effect size
# Install the effsize package if not already installed
# install.packages("effsize")

library(effsize)

# Calculate the effect size
effect_size <- cohen.d(before, after, paired = TRUE)

# Output the effect size
print(effect_size)
3. 結果の解釈
- The p値観察された変化が統計的に有意であるかどうかを示します。選択されたアルファ レベル (通常 0.05) 未満の p 値は、ペアの観察間に有意な差があることを示します。
- の評価 効果サイズ 差異の大きさについての洞察を提供し、これは調査結果の実際的な重要性を判断する上で非常に重要です。
よくある落とし穴とその回避方法
の実施と解釈 対応のあるt検定 実施と解釈は一見簡単そうに見えますが、いくつかの落とし穴によって不正確な結果が生じる可能性があります。こうしたよくある誤りを認識し、厳格な統計手法を遵守することは、倫理的な研究を行う上で非常に重要です。
対応のあるT検定を実施する際のよくある間違い:
ペアの不一致:各「前」測定値が、対応する「後」測定値と正しくペアになっていることを確認してください。ペアリングが間違っていると、誤った結論につながる可能性があります。
仮定を無視する:対応のあるt検定は、ペア内の差が正規分布に従うことを前提としています。検定を実行する前に、正規性を確認してください。正規分布に従わない場合は、ノンパラメトリック検定など、別の手法が必要になる場合があります。
外れ値:外れ値は、平均差と標準偏差に大きな影響を与える可能性があります。外れ値がデータ入力エラー、測定エラー、または真の値であるかどうかを判断するために、外れ値を調査してください。
サンプルサイズを見落としてはいけません。サンプルサイズが小さいと、有意な効果を検出するのに十分な検出力が得られず、第二種過誤につながる可能性があります。テストを実施する前に、研究の検出力が十分であることを確認してください。
データの依存性:対応のあるt検定は、従属的なデータ向けに設計されています。独立したサンプルに適用すると、結果が無効になります。
堅牢かつ倫理的な統計実践を確保するためのヒント:
分析前のデータチェック:データの正確性、正規性、外れ値について徹底的にチェックします。正規性の確認にはヒストグラムやQQプロットなどの視覚化ツールを、外れ値の確認には箱ひげ図などの視覚化ツールを活用します。
サンプルサイズ計算:事前に検出力分析を行い、関心のある効果を高い確率で検出するために必要なサンプルサイズを決定します。
報告の透明性:研究報告書には、データ変換や外れ値の除去など、分析中に実行されたすべての手順を含める必要があります。
効果量の報告:観察された効果の大きさに関する文脈を示すために、効果量とp値を報告してください。
複製と検証:可能な限り、研究結果を再現して、結果を確認し、信頼性を高めてください。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
仮説と統計的有意性
このセクションは、仮説の形成と統計的有意性の解釈の基礎的な側面に深く掘り下げます 対応のあるt検定の文脈における仮説の定式化と統計的有意性の解釈の基礎的な側面を掘り下げ、これらの要素が科学的探究において果たす重要な役割を強調します。
仮説を立てる
The paired サンプル t検定 は2つのコア仮説に基づいています: 帰無仮説 (H₀) といった 帰無仮説(H₀).
帰無仮説(H₀):この仮説は、ペアになった観測値間に有意差がないことを前提としています。これは、観測された差は特定の介入や条件によるものではなく、偶然によるものであることを示唆しています。数学的には、ペアになったサンプル間の平均差(D)がゼロ(D = 0)に等しいと表現されることがよくあります。
対立仮説(H₁):H₀とは対照的に、対立仮説は、ペアになった観測値間に有意差があることを提唱します。これは、介入または条件が測定可能な効果をもたらしたことを意味します。この仮説の性質は、両側検定(D ≠ 0)でどちらの方向にも差があることを示唆する場合と、片側検定(D > 0 または D < 0)で効果の特定の方向を示す場合があります。
統計的有意性を理解する
統計的有意性はに本質的に関連しています。p値と関連しています。この指標は、帰無仮説が真であるという仮定の下で、収集されたデータ、あるいはそれよりも極端な結果が観測される確率を定量化したものです。
A p値が低い(通常は0.05以下)ということは、観測されたデータが帰無仮説の下では極めて起こりにくいことを示し、帰無仮説は棄却され、対立仮説が採用される。これは、ペアになったサンプル間に統計的に有意な差があることを意味し、介入の効果が単なる偶然によるものではないことを示唆している。
逆に、高いp値帰無仮説を棄却するのに十分な証拠がないことを示唆しており、観察された差異はランダムな変動によるものである可能性があることを意味する。
結果の解釈
の結果の解釈 対応のあるt検定 の結果を解釈するには、単に統計的有意性を認めるだけでは不十分です。データが根本的な現象について何を明らかにしているのかを、より深く理解する必要があります。
統計的有意性と実用的有意性:統計的に有意な結果は、必ずしも実用的または臨床的な関連性を意味するものではありません。研究者は、介入の規模を示す指標である効果サイズを評価し、その現実世界における影響を判断する必要があります。
文脈的解釈:研究結果は、研究デザイン、サンプル特性、および外部要因の潜在的な影響を考慮し、研究課題のより広い文脈の中で解釈されるべきである。
倫理的な報告:研究結果の報告においては、方法論、統計的有意水準、効果量などを含め、透明性を確保することが極めて重要です。これにより、研究コミュニティは研究成果を批判的に評価し、それを基盤として発展させていくことができ、知識の累積的な進歩を促進することができます。
The paired サンプル t検定 ペアt検定のための厳密な仮説検定の枠組みを提供します。仮説を慎重に定式化し、統計的有意性を賢明に解釈することによって、研究者は真実の探求に貢献し、自然界とその無数の現象に対する理解を深める意味のある推論を引き出すことができます。
対応のあるT検定の仮定
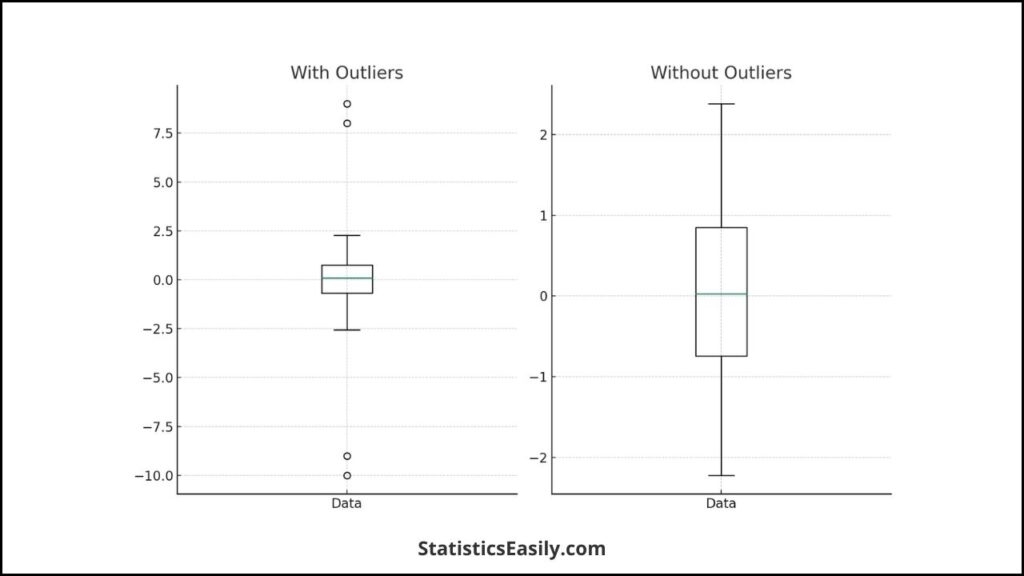
掘り下げるとき、 対応のあるt検定を深く理解するには、その根底にある前提条件を徹底的に理解し、遵守することが不可欠です。これらの前提条件は検定の妥当性の基盤であり、導き出される結論の信頼性と意義を保証するものです。ここでは、正規性と外れ値の検出に関して、それぞれの前提条件を詳細に解説し、理解を深めるための図解も併せて示します。
1. 観察結果のペアリング
一方のグループの各データ ポイントは、もう一方のグループに対応するペアを持っている必要があります。このペアリングは、介入の前後に同じ被験者が測定されるなど、共通の属性または条件に基づいています。この仮定の本質は、個人の変動を制御して、効果の集中的な分析を可能にすることです。
2. 測定の尺度
データは連続的または順序的であり、少なくとも間隔尺度で測定され、ペア間の差を意味のある形で計算できる必要があります。
3. ペアの独立性
各ペア内の観測値は関連していますが、各ペアは他のペアから独立している必要があります。この独立性は、1 つのペアの選択または結果が他のペアに影響を与えないという仮定に基づく t 検定の数学的基礎にとって重要です。
4. 差の正規分布
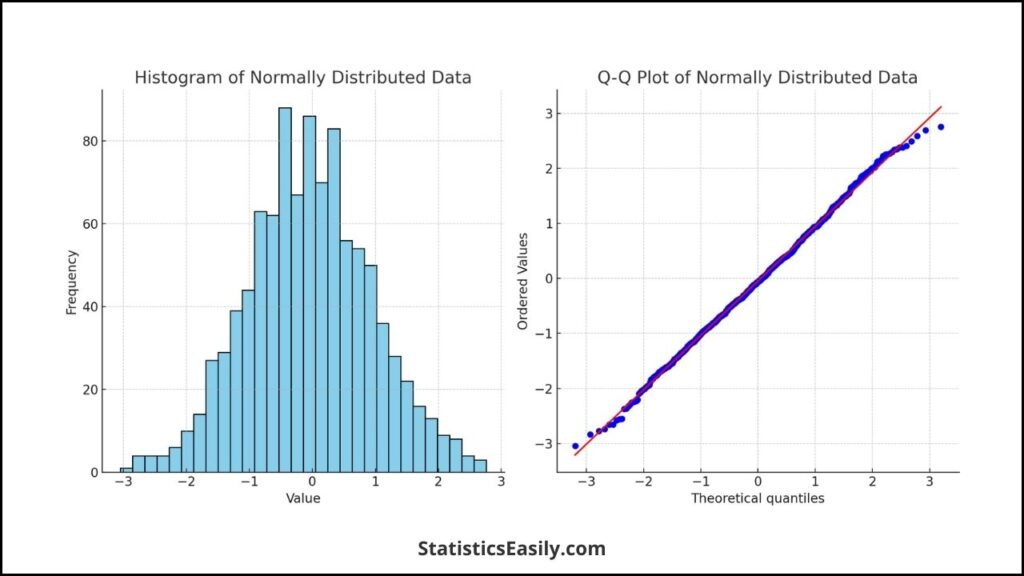
The paired サンプル t検定 対応のある観測値間の差が正規分布に従うことを前提としています。この前提は、2つのグループの個々の分布が正規分布に従うことを要求するものではなく、むしろそれらの差の分布が正規分布に従うことを要求します。データの正規性を確認するには、シャピロ・ウィルク検定を使用できます。
正規性の視覚的補助: ヒストグラムまたはQQプロットを使用して、差分の正規性を評価できます。ヒストグラムでは、ベル型の曲線は正規性を示唆します。QQプロットでは、点がほぼ直線に沿っている場合、分布は正規分布とみなすことができます。
違反への対処:
非正規分布: ペア間の差が正規分布に従わない場合は、変換を用いてデータを正規化することを検討してください。変換が効果的でない場合は、ウィルコクソン符号順位検定などのノンパラメトリックな代替手法の方が適している場合があります。
外れ値:外れ値は対応のあるt検定に不均衡な影響を与え、誤解を招く結果につながる可能性があります。
- 外れ値の視覚的補助:箱ひげ図は、外れ値を識別するのに特に効果的です。箱ひげ図のひげの外側にある点は外れ値とみなされる可能性があります。
- 外れ値の処理: 外れ値が特定されたら、データ入力エラーや測定異常がないか調査します。外れ値が正当な観測値である場合は、分析への影響を慎重に検討します。場合によっては、影響を軽減するために、堅牢な統計手法や調整が必要になることがあります。
実用的な考慮事項
これらの仮定を確認するための予備分析を実施してから、対応のあるt検定を実施する前に、これらの仮定を検証するための予備分析を行うことは不可欠です。この先を見越したアプローチは、研究結果の妥当性を高め、厳密かつ倫理的な科学的探究の原則に合致するものです。
対応のあるT検定の手順と計算
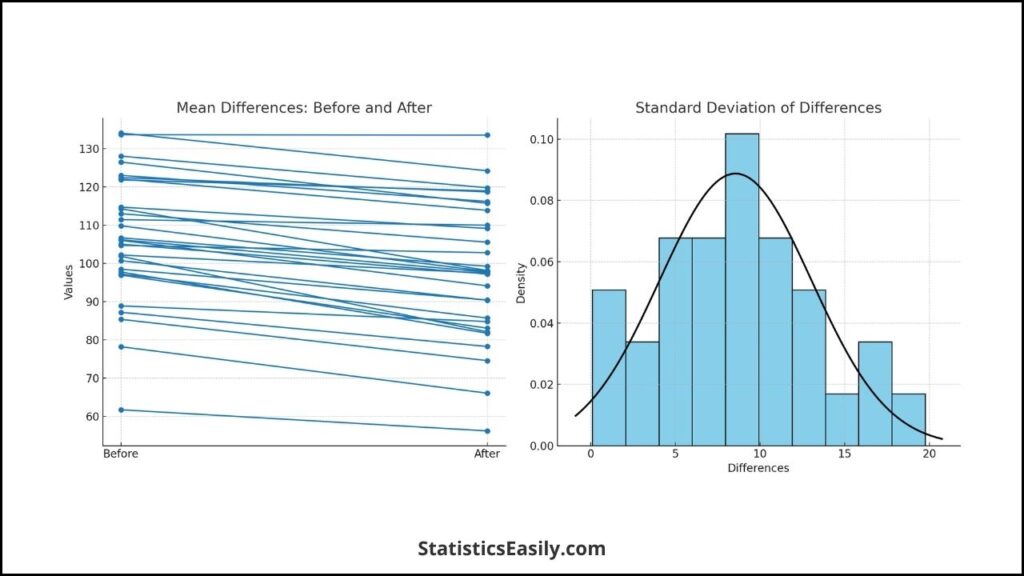
このセクションは、の実行に関する詳細なステップバイステップガイドを提供します 対応のあるt検定実行するための詳細な手順を段階的に説明します。平均差、標準偏差、およびt統計量の計算に焦点を当て、分かりやすくするために視覚的な例も添えています。
データの収集と準備
- データを集めます: 関連する 2 セットの測定からペア データを収集し、各「前」の測定が対応する「後」の測定とペアになっていることを確認します。これには、同じ対象者に対する介入前と介入後の評価が含まれる場合があります。
- クリーンなデータ: データがクリーンで、正しく一致しており、結果を歪める可能性のある外れ値がないことを確認します。データのクリーニングは、テスト結果の精度にとって非常に重要です。
Rでの実行
- I入力データ: データをRにインポートし、2つの列に並べて、 '前に' と '後' 条件。各行が一致するペアに対応していることを確認します。
- 対応のあるT検定を実行する: Rを使う ‘t.test()’ 対合t検定を実行する関数。基本的な構文は 't.test(前、後、ペア = TRUE)', where '前に' と '後' データ ベクトルを表します。この関数は、平均差の t 統計量、p 値、および信頼区間を計算します。
# R code example
before <- c(1, 2, 3, 4, 5)  # Sample 'before' data
after <- c(2, 3, 4, 5, 6)   # Sample 'after' data

# Perform paired t-test
test_result <- t.test(before, after, paired = TRUE)

# Print the test result
print(test_result)

# Calculate Cohen's d for effect size
install.packages("effsize") # Install the effsize package if not already installed

library(effsize) # Run the effsize package

# Calculate the effect size
effect_size <- cohen.d(before, after, paired = TRUE)

# Output the effect size
print(effect_size)
対応のあるT検定の計算の詳細
平均差:各観測値のペア間の差を計算します。これらの差の平均(D)は、t検定の重要な要素です。
差の標準偏差:差の標準偏差(SD)を計算して、ばらつきを測定します。
t統計量:t統計量は次の式を用いて計算されます。
t = D / (SD / √n)
ここで、n はペアの数です。この統計は、平均差がゼロから何標準偏差離れているかを測定します。
t 統計量を計算した後に対応のあるt検定でt統計量を計算した後、次のステップではp値を決定し、自由度(df)を考慮して検定結果を正確に解釈します。手順は以下のとおりです。
P値の決定
p 値は仮説検定において重要な要素であり、帰無仮説が正しいと仮定して、観測された結果と少なくとも同程度に極端な検定結果が得られる確率を示します。t 統計量を計算した後、次のようになります。
- 自由度 (df): 対応のあるt検定の場合、自由度は次のように計算されます。df = n−1、ここでnペアの数です。自由度は、統計の最終的な計算で自由に変化する値の数を表します。
- T分布表を参照: 計算された t 統計量と自由度を使用して、t 分布表を参照して p 値を見つけます。t 分布表は、さまざまな有意水準 (アルファ レベル) におけるさまざまな自由度の臨界値を提供します。
- ソフトウェア計算R のような統計ソフトウェアは、t 検定を実行するときに p 値を自動的に計算します。ソフトウェアは t 統計量と自由度を使用して確率を計算します。
視覚的な例
平均差:各ペアの「介入前」と「介入後」の値を表示する折れ線グラフは、平均差を視覚的に表し、介入の効果を強調することができます。
標準偏差:差分のヒストグラムに正規分布曲線を重ね合わせることで、差分のばらつきと正規性を視覚的に把握できます。
結果の解釈
- P値: アルファレベル (通常は 0.05 に設定) 未満の p 値は、ペアになったグループ間に統計的に有意な差があることを示し、観察された変化が偶然に発生した可能性は低いことを示唆します。
- 効果の大きさ: Cohen の d などの効果サイズを計算すると、観察された差の大きさについての洞察が得られ、統計的有意性にコンテキストが追加されます。
- 信頼区間平均差の信頼区間は、真の平均差が含まれる可能性のある範囲を示し、結果の精度を測定します。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
結論
この包括的なガイドでは、の複雑さに深く掘り下げました。 paired サンプル t検定の複雑な仕組みについて詳しく解説しました。この統計的手法は、科学研究において極めて重要な役割を果たします。この検定は、異なる条件下で同一被験者から得られた2つの観測値を比較するのに役立ち、医学、心理学、教育など様々な分野における介入の効果を評価するための強固な枠組みを提供します。
要点の要約:
- The 対応のあるt検定精度を高める データ分析 個人差をコントロールすることで、治療や介入の真の影響を見極める強力なツールとなります。
- 一対の差の正規分布や観測値の独立性など、テストの仮定に従うことは、結果の妥当性にとって最も重要です。
- The 対応のあるt検定の実用的な応用はさまざまな分野に及び、その汎用性と実証的研究における重要な役割を実証しています。
- 不一致のペアや外れ値の見落としなどの潜在的な落とし穴を回避するには、綿密なデータ準備と倫理的な統計手法が必要です。
科学的発見というより広い文脈において、 対応のあるt検定 科学的方法の厳密さを体現しており、自然界に対する私たちの理解の根底にある経験的真実への窓を開くものです。慎重な実施と解釈を通して、 paired サンプル t検定 知識の進歩に貢献し、科学的誠実性の原則を堅持します。
本質的に、 対応のあるt検定 単なる統計ツール以上のものです。それは、知識への飽くなき探求の証です。科学的精神を体現し、データという糸を紡ぎ合わせて、介入の効果とそれが人々の幸福に及ぼす影響を明らかにする、首尾一貫した物語を紡ぎ出します。この分析ツールの力を活用するにつれ、私たちは研究結果が学術界だけでなく、社会全体にとってより広範な意味を持つことを改めて認識させられます。
科学探究という壮大なタペストリーにおいて、 対応のあるt検定 、経験的証拠と真理という哲学的理想を結びつける重要な糸である。この統合を通して、対応 対応のあるt検定 のような統計的手法が、人類の知識という豊かなタペストリーに貢献し、すべての人々の幸福のために科学探究という崇高な営みを推進する上で果たす役割を真に理解することができる。
おすすめ記事
ブログの関連記事のコレクションを詳しく調べて、統計テストとデータ分析に関するさらなる洞察を探りましょう。
よくある質問(FAQ)
Q1:対応のあるt検定は何のために使われるのですか?対応のあるt検定は、主に2つの関連するグループの平均値を比較し、統計的に有意な差があるかどうかを判断するために使用されます。この検定は、「前後比較」研究や、同じ被験者を2つの条件下で測定する場合に最適です。
Q2:対応のあるt検定とANOVAの違いは何ですか?対応のあるt検定は関連する2つのグループの平均値を比較するのに対し、ANOVA(分散分析)は3つ以上のグループまたは異なる水準の因子の平均値を比較する場合に使用されます。ANOVAは、単純な対応のある比較よりも複雑な設計を扱うことができます。
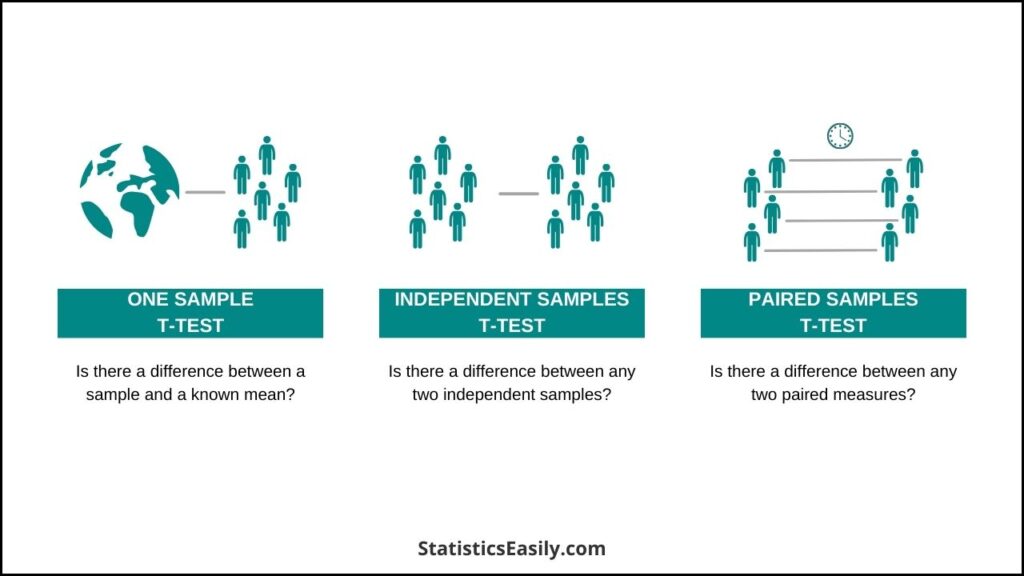
Q3: t検定にはどのような種類がありますか?t検定の主な種類は次の3つです。1) 1標本t検定:1つのグループの平均を既知の平均と比較します。2) 独立2標本t検定:2つの独立したグループの平均を比較します。3) 対応のあるt検定:同じグループまたは一致する被験者の平均を、2つの異なる時点または2つの異なる条件下で比較します。
Q4:対応のあるt検定と1標本t検定の違いは何ですか?対応のあるt検定は、同じまたは一致する被験者の平均値と2つの異なる条件を比較し、これらのペアになった観測値の差に焦点を当てます。一方、1標本t検定は、単一の標本の平均値と既知または仮説上の母集団の平均値を比較します。
Q5: R で対応のある t 検定を実行するには、まず、R で対応のある t 検定を実行するには、データが対応のある観測値で構造化されていることを確認します。通常は、各行がペアを表す 2 つの列です。't.test‘t.test()’関数を使用して、2 つのデータベクトルを指定し、'paired'引数を引数として'TRUE'に設定します。この関数は、t 統計量、自由度、p 値などの情報を返します。'before前に'と'後'対応のある観測値のベクトルであると仮定した基本的な例を以下に示します't.test(前、後、ペア = TRUE)'。このコマンドは、データに対して対応のある t 検定を実行し、'前に'と'後'条件を比較して、解釈に必要な統計出力を提供します。
Q6: 対応のあるt検定は非正規データに使用できますか?有意に非正規分布データの場合、ペアt検定はペア間の差が正規分布に従うことを前提としているため、ウィルコクソン符号順位検定などのノンパラメトリックな代替手法が推奨されます。
Q7:対応のあるt検定の結果はどのように解釈しますか?解釈はp値に焦点を当てます。p値が選択した有意水準(一般的には0.05)を下回る場合、対応のあるグループ間の差は統計的に有意であるとみなされ、偶然を超えた真の効果を示しています。
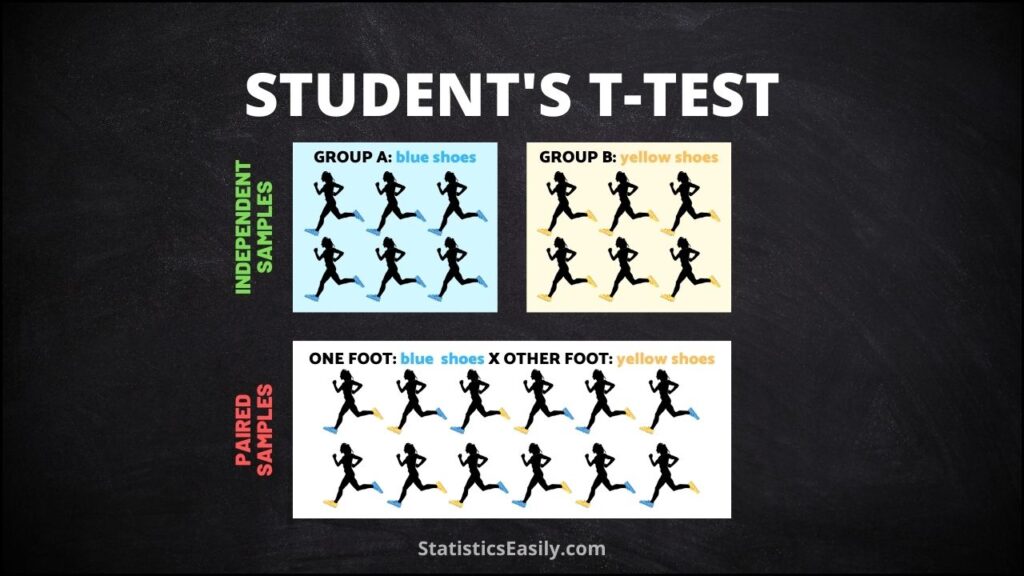
Q8:対応のあるt検定と独立t検定の違いは何ですか?対応のあるt検定は、関連するサンプルまたは対応のあるペアに対して使用され、ペア内の差を分析します。独立t検定は、2つの独立した、または関連性のないグループの平均値を比較し、グループ間の分散に焦点を当てます。
Q9:対応のあるt検定では、欠損データはどのように処理されますか?対応のあるt検定では、ペアの一方の値が欠損している場合、通常はペア全体が分析から除外されます。この方法は、欠損値を補完することによって生じる可能性のあるバイアスを防ぎます。ただし、除外されるペアが多い場合は、検定力が低下する可能性があります。
Q10:対応のあるt検定は、2つ以上の時点の比較に使用できますか?対応のあるt検定は、2つの時点または条件間の比較のために設計されています。2つ以上の時点を含む分析では、複雑さが増すため、反復測定分散分析または混合効果モデルの方が適切です。