クラスカル-ウォリス検定: 複数グループのノンパラメトリック分析をマスターする
さまざまな研究シナリオにクラスカル-ウォリス テストを正確に適用するための重要な手順を学びます。
イントロダクション
正規分布を仮定せずに、さまざまな薬剤が患者の回復時間にどのように影響するかを理解できると想像してみてください。そこで登場するのが、従来のパラメトリック検定の限界を超越する、ノンパラメトリック統計分析の強力なツールであるクラスカル・ウォリス検定です。複数のグループ間で中央値を比較するために設計されたこの検定は、非正規分布または順序尺度データ分布を扱う研究者にとって重要です。この検定は、以下の情報を提供します。
- 重要な違いを識別するための堅牢な方法。
- 多様なデータセットから収集した洞察が正確かつ信頼できるものであることを保証します。
- 統計手法における極めて重要な進歩を示します。
ハイライト
- クラスカル-ウォリス検定は、非正規データ分布に最適です。
- 複数のグループの中央値を効果的に比較します。
- データが厳密な分散均一性を満たす必要はありません。
- サンプルサイズが小さい場合でも大きい場合でも適用可能です。
- H 統計量と p 値を解釈すると、グループの違いが明らかになります。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
背景と理論
統計分析において、ノンパラメトリック統計、正規分布や分散の均一性といったパラメトリック検定の従来の仮定に頼ることなくデータを分析するための重要な枠組みを提供する。クラスカル・ウォリス検定を含むノンパラメトリック手法は、順序尺度データを扱う場合や、パラメトリック検定に必要な分布仮定を検証するにはサンプルサイズが小さすぎる場合に特に有用である。
ノンパラメトリック統計を理解する
ノンパラメトリック統計は、分析されたデータの基礎となる確率分布を推定しません。これにより、パラメトリックな仮定が満たされないさまざまな状況に非常に汎用性が高く、適用できるようになります。ノンパラメトリック検定は、歪んだ分布や順序データに特に役立ち、データの測定スケールがパラメトリックな仮定をサポートしていない場合に堅牢な代替手段を提供します。
クラスカル・ウォリス検定: 詳細を見る
The クラスカル・ウォリス検定、一元配置分散分析(ANOVA)のノンパラメトリックな代替手法であり、連続変数または順序変数である従属変数に対して、独立変数の2つ以上のグループ間に統計的に有意な差があるかどうかを判断するために使用されます。特に、ANOVAの前提条件が成り立たない複数のグループに適用できる点が注目に値します。
仮定
- 従属変数は、連続データ、順序データ、またはカウント データである必要があります。
- 従属変数は連続変数または順序変数である必要があります。
- 独立変数は、2 つ以上のカテゴリ別の独立したグループで構成されている必要があります。
- グループ間の観察は独立している必要があります。
注: データは正規分布に従う必要はないため、 クラスカル・ウォリス検定 ノンパラメトリック手法となります。
分散分析との比較
ANOVA 検定は分散の正規性と均一性の仮定を満たすデータに依存しますが、クラスカル-ウォリス検定はそうではありません。代わりに、データをランク付けし、これらのランクの合計をグループ間で比較するため、非正規分布や順序データに適しています。ただし、ANOVA とは異なり、平均の差を直接検定するのではなく、グループ間の中央値または分布の差を検定します。
主要なポイント(要点)
- データが正規性の仮定を満たさない場合には、クラスカル-ウォリス検定のようなノンパラメトリック統計が不可欠です。
- クラスカル-ウォリス検定は、ANOVA などのパラメトリック検定で必要とされる厳密な仮定を必要とせずに、複数のグループ間の差異を分析するのに役立ちます。
- 幅広い分野や研究シナリオに適用できるため、統計分析における多用途のツールとなります。
クラスカル・ウォリス検定の効果の大きさと種類
クラスカル-ウォリス検定では、複数のグループにわたる有意な差が特定されますが、これらの違いによる実際的な影響を識別するには、効果量の計算が必要です。エフェクト サイズ メトリクスは、統計的有意性を定量化可能な影響尺度に変換し、現実世界での適用と解釈に不可欠です。
効果量の標準的な尺度
適応イータ二乗(η²):従来ANOVAで用いられてきたη²は、Kruskal-Wallis検定のH統計量を全分散に関連付けることで、Kruskal-Wallis検定にも適用できます。この適応により、効果の大きさを推定できます。ただし、データのノンパラメトリックな性質を考慮して解釈する必要があります。
イプシロン二乗(ε²):クルスカル・ウォリス検定用に設計されたε²は、データのノンパラメトリックな順位付けを考慮し、グループ間の差によって説明される分散についての洞察を提供します。これは、パラメトリックな仮定に頼ることなく効果量を定量化することで、検定結果を補完する、より繊細な指標です。
追加のノンパラメトリック効果量測定
コーエンのd(ノンパラメトリック用に調整):事後ペアワイズ比較を行う場合、グループ間の標準化された差を定量化するために、コーエンのdの調整版を適用できます。この調整では、比較が順位に基づいていることを考慮する必要があります。
順位双列相関係数:この指標は、グループ間の平均順位を比較することで、相関係数として直感的な効果量を提供します。特にユーザーフレンドリーで、幅広い層が理解しやすい、分かりやすい効果量の解釈が可能です。
これらの効果量の計算をクラスカル-ウォリス検定分析に組み込むと、統計的なナラティブが強化され、結果が統計的に有意であり、実用化に明確な影響を与えることが保証されます。グループの違いの大きさを定量化することで、研究者は結果の現実世界との関連性をより効果的に伝えることができます。
クラスカル-ウォリス検定の事後テスト
クラスカル-ウォリス検定で有意な結果が見つかった場合、多くの場合、グループ間の違いがどこにあるのかを正確に特定するために事後テストを実行する必要があります。これらのテストでは次のことが提供されます。
- 詳細なペアごとの比較。
- どの特定のグループが互いに異なるかを理解するのに役立ちます。
- したがって、データに対するより深い洞察が得られます。
クラスカル-ウォリス検定で重要な結果を特定した後、特定のグループの違いを正確に特定するには、事後分析が不可欠です。重要なテストは次のとおりです。
ダンのテスト
- それは何ですか: グループのペア間のランクを比較するために広く使用されているノンパラメトリックな方法。
- 使用法: クラスカル-ウォリス テストで全体的な大きな差異が示された後の詳細な分析に適しています。
- 特性: 多重比較の調整を組み込んで、タイプ I エラーのリスクを最小限に抑えます。
ネメニテスト
- それは何ですか: Nemenyi テストは、ANOVA で使用される Tukey HSD テストに似たノンパラメトリック アプローチで、ランク合計に基づいて複数のペアごとの比較を実行するように設計されています。
- 使用法: このテストは、主にすべてのグループを他のすべてのグループと比較することを目的とする場合に、重要なクラスカル-ウォリス テストに続きます。
- 特性: 正規分布を仮定せずに包括的な分析を提供するため、さまざまな種類のデータに適用できます。この検定は、グループ間のペアごとの差異の詳細な概要を提供するのに役立ちます。
コノバーのテスト
- それは何ですか: ダンの検定に似たペアごとのグループ比較のノンパラメトリック検定ですが、p 値の調整に別の方法が使用されます。
- 使用法: クラスカル-ウォリス後に、より微妙なペアごとの比較が必要な場合に適用されます。
- 特性: さまざまなデータ型に適した代替の p 値調整方法を提供します。
ドワス・スチール・クリッチロー・フリグナー (DSCF) テスト
- それは何ですか: 複数のペアごとの比較に合わせて調整されたノンパラメトリック手法。
- 使用法: クラスカル・ウォリス後の分析に最適で、正規分布を仮定しない包括的なペア比較フレームワークを提供します。
- 特性: 複数のテストを調整し、統計的結論の整合性を確保します。
マン・ホイットニーの U 検定
- それは何ですか: ウィルコクソン順位和検定としても知られ、2 つの独立したグループを比較します。
- 使用法: クラスカル-ウォリス後のペアごとの比較、特に特定のグループの違いを分析する場合に適しています。
- 考慮事項: 多重比較用に設計されていません。タイプ I の誤り率を管理するには、調整 (ボンフェローニ補正など) が必要です。
各テストには独自の機能と適用性があり、クラスカル-ウォリス テスト後の事後分析に貴重なツールとなります。特定の研究課題、データの特性、およびタイプ I エラー制御の必要性を考慮して、テストを選択してください。
クラスカル・ウォリス検定を使用する場合
The クラスカル・ウォリス検定、複数の独立したグループ間で中央値を比較するためのノンパラメトリックな手法です。ANOVAなどのパラメトリック検定に必要な前提条件が満たされない場合に有効です。以下に、クルスカル・ウォリス検定が最も適している具体的な状況を示します。
非正規分布データ:データが正規分布に従わない場合、特に中心極限定理が適用されない小さなサンプルサイズの場合、クラスカル・ウォリス検定は信頼できる代替手段となります。
順序尺度データ:このテストは、順序尺度で測定されたデータに対して、グループ間の比較を効果的に行うことができます。順序尺度では、レベル間の数値的な差は一貫しておらず、意味もありません。
分散の不均一性:グループ間で分散が異なる場合でも、多くのパラメトリック検定とは異なり、Kruskal-Wallis検定を適用できます。
サンプルサイズが小さい場合:サンプルサイズが小さすぎてパラメトリック検定の前提条件を確実に検証できない場合は、クラスカル・ウォリス検定の方がより適切な選択肢となる可能性があります。
例:
を適用することによってクラスカル・ウォリス検定適用することで、研究者はパラメトリック検定に必要な厳密な前提条件なしに、グループ間の違いに関する信頼性の高い知見を得ることができます。これにより、多様な研究分野における統計分析の堅牢性と適用性が向上し、研究結果が正確で方法論的に健全な手法に基づいていることが保証されます。
臨床研究:3種類の異なる薬剤の鎮痛効果を比較し、鎮痛レベルを順序尺度(例:鎮痛なし、軽度鎮痛、中等度鎮痛、完全鎮痛)で評価する。
環境科学:さまざまな汚染物質が植物の成長に与える影響を評価する。成長は順序尺度(例:成長なし、成長が遅い、成長が中程度、成長が速い)に分類され、データは歪んでいるか、正規性の仮定を満たさない。
マーケティング研究:小売チェーンの複数の店舗における顧客満足度を評価する。満足度はリッカート尺度(例:非常に不満、不満、どちらでもない、満足、非常に満足)で測定される。
教育研究:さまざまな教授法におけるテストスコアの向上を分析し、その向上を分類(例:改善なし、わずかな改善、中程度の改善、著しい改善)し、データの分布が不明または非正規分布である場合。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
クラスカル・ウォリス検定を計算するためのステップバイステップ ガイド
クラスカル-ウォリス検定は、3 つ以上の独立したグループの中央値間に統計的に有意な差があるかどうかを判断するために使用されるノンパラメトリック統計検定です。このガイドでは、このテストの実行に必要な手動計算について説明し、明確でわかりやすいアプローチを提供します。
データの準備
1. データの収集:データが整理されていることを確認してください。1つの列は独立変数(グループ)を表し、もう1つの列は従属変数(グループ間で比較したいデータ)を表します。
2. 前提条件の確認:データがクラスカル・ウォリス検定の前提条件を満たしていることを確認してください。この検定では、各グループのデータが独立していること、および従属変数が少なくとも順序尺度であることが必要です。
手動計算
1. データの順位付け:すべてのグループ観測値を1つのデータセットにまとめ、小さい順から大きい順に順位付けします。同順位がある場合は、平均順位を割り当てます。
2. 順位の合計:各グループの順位の合計を計算します。
3. 検定統計量(H)を計算する:
クラスカル-ウォリス H 統計の式は次のとおりです。
ここで、n は観測の総数、 k はグループの数, Ri は i はiの順位の合計です。番目のグループの順位の合計、niiの観察の数は番目のグループの観測数です。
4. 自由度を決定する:これは、比較対象のグループ数より1少ない値です。
5. 臨界値を求める:カイ二乗(χ)分布表を使用して、自由度と選択した有意水準(一般的には0.05)に対応する臨界値を求めます。
6. H を臨界値と比較する: 計算した H 統計量が: 計算された H 統計量がの臨界値より大きい場合χ2 表の臨界値より大きい場合、帰無仮説を棄却し、グループ間に有意差があると結論付けることができます。
効果量の計算 (η2)
クルスカル・ウォリス検定は本来、効果量を示すものではありませんが、効果量を推定する一つの方法として、イータ二乗(η²)を用いる方法がありますη2)、次のように計算されます:
η2 = (H – k + 1)/(n – k)
ここで、H はクラスカル-ウォリス統計量、k はグループの数、n は観測値の合計数です。
これは、データの分散がどの程度グループの違いによって説明されるかを示す尺度を提供します。
視覚的表現
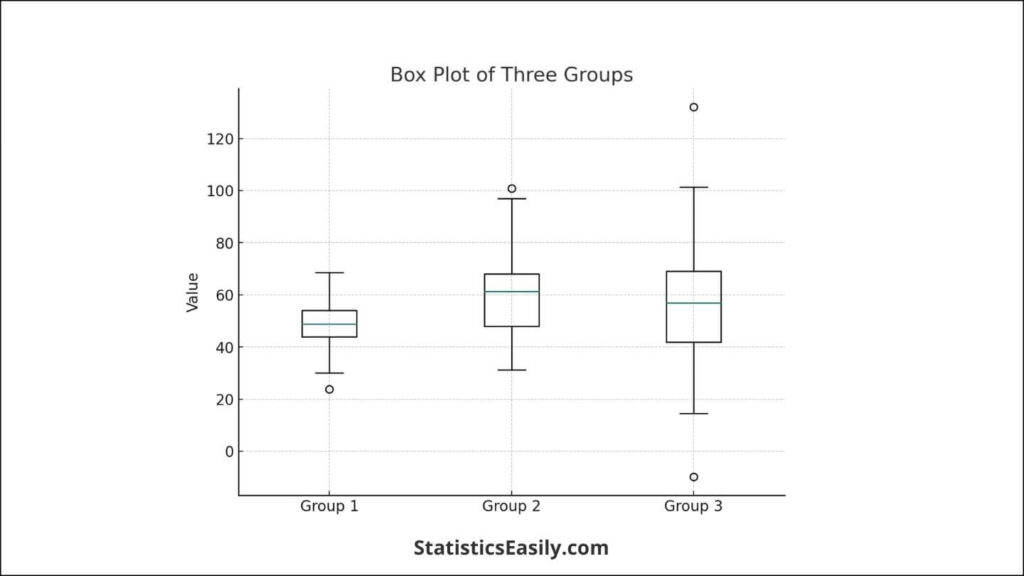
箱ひげ図を作成して、グループ全体のデータの分布を視覚化することを検討してください。これは、データを理解し、結果を説明するのに役立ちます。
R でクラスカル・ウォリス検定を実行する方法
このガイドでは、効果量の計算や多重比較のための事後テストの実施など、R を使用したクラスカル・ウォリス検定の実行に関する詳細なステップバイステップのチュートリアルを提供します。
データの準備:
1. データ入力:まず、データがRで正しくフォーマットされていることを確認します。通常、独立変数(グループ化要因)を表す列と、従属変数(比較したいスコアまたは測定値)を表す列がそれぞれ1つずつあります。
# Sample data creation
set.seed(123)  # For reproducibility
group <- factor(rep(c("Group1", "Group2", "Group3"), each = 20))
score <- c(rnorm(20, mean = 50, sd = 10),
           rnorm(20, mean = 55, sd = 15),
           rnorm(20, mean = 60, sd = 20))
data <- data.frame(group, score)
2. データ検査:テストを実行する前にデータを視覚化して検査することは非常に重要です。ボックスプロットを使用して、グループ間の分布を評価します。
# Data visualization
boxplot(score ~ group, data = data, main = "Group Comparison", ylab = "Scores", xlab = "Group")
クラスカル・ウォリス検定の実行:
1. テストを実行する: R の kruskal.test() 関数を使用して、従属変数と独立変数を指定します。
# Kruskal-Wallis Test
kruskal_test_result <- kruskal.test(score ~ group, data = data)
print(kruskal_test_result)
2. 結果の解釈:出力には、クラスカル・ウォリス統計量とそれに対応するp値が表示されます。有意なp値(通常は0.05未満)は、グループ間で中央値に差があることを示します。
効果量の計算:
1. イータ二乗を計算する:クルスカル・ウォリス検定は直接効果量を提供するものではありませんが、イータ二乗(η²)を推定値として使用できます。
# Effect size calculation
eta_squared <- kruskal_test_result$statistic / length(data$score)
print(eta_squared)
事後分析:
1. 事後検定の実施:クルスカル・ウォリス検定で有意差が認められた場合、どのグループ間に差があるかを特定するために事後検定を実施する必要がある場合があります。この目的には、ボンフェローニ補正を適用したpairwise.wilcox.test()関数を使用できます。
# Post-hoc analysis
post_hoc_result <- pairwise.wilcox.test(data$score, data$group, p.adjust.method = "bonferroni")
print(post_hoc_result)
2. 事後分析結果の解釈:これにより、グループ間のペアワイズ比較が可能になり、有意な差が明らかになります。
クラスカル・ウォリス検定の結果の解釈
の結果を理解するクラスカル・ウォリス検定の結果を理解するには、H統計量は, p値, and 効果量など、いくつかの重要な要素を分析する必要があります。さらに、有意差が認められた場合は、事後分析によって特定のグループ間の差異を特定することが重要です。本節では、これらの要素を明確にし、分析結果の包括的な概要を提供します。
H 統計量と P 値
The H統計量はクルスカル・ウォリス検定の中核となる結果であり、異なるグループ間の順位のばらつきを示します。H値が大きいほど、グループ間の中央値の差が大きいことを意味します。この統計量を解釈するには、次の手順に従ってください。
- H 値は、自由度 (グループ数 - 1) を考慮して、カイ二乗分布の臨界値と比較されます。
- The p値H 統計に関連付けられた は、帰無仮説の下で、特定の結果、またはより極端な結果が観察される確率を示します。事前定義されたアルファ レベル (通常は 0.05) を下回る p 値は、少なくとも XNUMX 組のグループ中央値の間で統計的に有意な差があることを示します。
エフェクトサイズ
効果量は、観察された差異の大きさを定量化し、統計的有意性を超えた解釈の次元を提供する。クルスカル・ウォリス検定では、イータ二乗(η²)が一般的に用いられる指標であり、グループ間の差異に起因する順位の分散を反映する。イータ二乗値の解釈は以下のとおりである。
- 影響が小さい: η² ≈ 0.01
- 中程度の効果: η² ≈ 0.06
- 大きな効果: η² ≈ 0.14
複数の比較と事後テスト
クルスカル・ウォリス検定で有意な結果が得られた場合は、グループ間の明確な差を特定するために、事後検定によるさらなる検討が必要です。これらの検定には、異なるグループの違いを特定するために。これらのテストにはダン検定, ネメニ検定, and コノバー検定などがあり、それぞれ特定の条件とデータタイプに合わせて調整されています。事後分析を実施する際の重要なポイントは以下のとおりです。
- 研究の目的とデータの属性に合った事後テストを選択してください。
- これらのテストは本質的に、複数の比較によるタイプ I エラーのリスクを調整し、推論プロセスの整合性を保証します。
よくある落とし穴と回避戦略
- 重要性の過度の強調: 有意な p 値は、自動的に意味のある効果または大きな効果を意味するわけではありません。バランスの取れた解釈をするには、効果の大きさの考慮事項を統合することが重要です。
- 分布の仮定: クラスカル-ウォリス検定は、パラメトリックな対応物よりも仮定に縛られませんが、理想的には、中央値の差を除いて、グループ全体で同等の分布形状を必要とします。この類似性を確保することで、テストの有効性が高まります。
これらのコンポーネントを正確にナビゲートすることで、研究者はクラスカル・ウォリス検定から正確かつ有意義な結論を導き出し、データの基礎となるパターンと関係についての理解を深めることができます。
ケーススタディとアプリケーション
The クラスカル・ウォリス検定、3つ以上の独立したグループを比較するための強力なノンパラメトリック手法です。本節では、クルスカル・ウォリス検定の有効性とそこから得られる知見を説明するために、実際の応用例と架空のケーススタディを紹介します。
現実世界への応用: 環境科学
環境調査では、研究者らは複数の場所にわたる特定の植物種の成長率に対する産業汚染の影響を評価することを目的としていました。サイトは工業地域への近さに基づいて、高汚染地帯、中程度の汚染地帯、低汚染地帯の 3 つのグループに分類されました。成長率の非正規分布とデータの順序性を考慮して、Kruskal-Wallis 検定が使用されました。
この試験により、3つのグループ間で成長率の中央値に有意差があることが明らかになった(H統計量はp < 0.05で有意)。これは、汚染レベルが植物の成長に大きく影響することを示している。この知見に基づき、重要地域における産業排出量の削減に焦点を当てた、的を絞った環境政策が策定された。
仮説的な例: ヘルスケア研究
仮想的な研究を考えてみてください医療分野における架空の研究を考えてみましょう。研究者たちは、慢性疾患に対する3つの異なる治療プロトコルの有効性を調査します。患者は3つの治療グループのいずれかにランダムに割り当てられ、評価指標は生活の質の改善であり、これは順序尺度で採点されます。
研究者らは、クラスカル・ウォリス検定を利用して、治療グループ間の改善スコアの中央値に統計的に有意な差があることを発見しました。さらに事後分析を行うことで、どの特定の治療法が大きく異なるのかが特定され、医療専門家がより効果的な治療プロトコルに導かれます。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
結論
この記事全体で、私たちはの探求を行いましたクラスカル・ウォリス検定について解説し、複数のグループにわたるノンパラメトリックデータを扱う際の統計分析におけるその重要な役割を強調しました。この検定の強みは、正規性の仮定を満たさないデータにも対応できる点にあり、従来のANOVAに代わる強力な手法となります。環境科学から医療まで、さまざまな分野で応用されており、意思決定や政策立案に役立つ有益な知見を得るのに貢献しています。クルスカル・ウォリス検定は、真実の探求を体現するものであり、研究者がデータに潜むパターンを解明し、エビデンスに基づいた実践を促進することで、社会全体の利益に貢献します。
おすすめ記事
私たちのブログの詳細な記事のコレクションを探索して、最先端の統計手法とその応用を発見してください。
- 一元配置分散分析をマスターする: 初心者向けの包括的なガイド
- マン・ホイットニー U テストをマスターする: 総合ガイド
- 一元配置分散分析で避けるべきよくある間違い
- ノンパラメトリック統計: 包括的なガイド
- MANOVA: データサイエンティストのための実践ガイド
よくある質問(FAQ)
Q1:クラスカル・ウォリス検定とは何ですか?クラスカル・ウォリス検定は、3つ以上の独立したグループ間で中央値を比較するために使用されるノンパラメトリック統計手法です。データが一元配置分散分析などのパラメトリック検定に必要な前提条件を満たさない場合に有効です。
Q2:クラスカル・ウォリス検定はどのような場合に使用すべきですか?この検定は、正規分布に従わない場合、順序尺度データ、分散が不均一な場合、および従来のパラメトリック検定の前提条件を満たせない小規模サンプルサイズの場合に適しています。
Q3:クラスカル・ウォリス検定はANOVAとどのように異なりますか?ANOVAとは異なり、クラスカル・ウォリス検定はデータの正規分布や分散の均一性を仮定しません。データを順位付けし、グループ間の順位の合計を比較するため、非正規分布や順序尺度データに最適です。
Q4:クラスカル・ウォリス検定の前提条件は何ですか?主な前提条件としては、従属変数が連続変数または順序変数であること、独立変数が2つ以上のカテゴリカルな独立したグループで構成されていること、およびグループ間の観測値が独立していることが挙げられます。
Q5:クルスカル・ウォリス検定は事後分析に使用できますか?はい、有意な結果が得られた場合、ダン検定、ネメニ検定、コノバー検定、ドワス・スティール・クリッチロー・フリグナー検定、マン・ホイットニーU検定(調整あり)などの事後検定を実施して、特定のグループ間の違いを特定できます。
Q6: クラスカル・ウォリス検定では、効果量はどのように計算されますか?効果量は、修正イータ二乗(η²)、イプシロン二乗(ε²)、ノンパラメトリック用に修正されたコーエンのd、およびランク双列相関係数を使用して定量化でき、グループ間の差の大きさについての洞察が得られます。
Q7:クルスカル・ウォリス検定の実際的な応用例にはどのようなものがありますか?この検定は、臨床研究、環境科学、マーケティング研究、教育研究などで広く用いられており、主に順序尺度データ、非正規分布、またはサンプルサイズが小さい場合に適用されます。
Q8:クルスカル・ウォリス検定では、データはどのように分析されますか?データはすべてのグループにわたって順位付けされ、この検定では、平均値の差ではなく中央値の差に焦点を当て、グループ間で順位の分布に有意な差があるかどうかを評価します。
Q9:クルスカル・ウォリス検定の結果を解釈する際に考慮すべき点は何ですか?この検定はグループ間の差が統計的に有意かどうかを示しますが、その差がどの位置にあるかは特定しません。詳細なペアワイズ比較を行うには、事後検定が必要です。
Q10:クラスカル・ウォリス検定には限界がありますか?はい、この検定では平均値の差に関する情報が得られず、詳細な分析には事後分析が必要です。また、ペアデータや反復測定データには対応していません。