


データサイエンティストが記憶について忘れていること
メモリが実際にどのように動作するかを理解することで、より堅牢で効率的かつ予測可能なコードを作成するためのデータ アナリストおよび科学者向けのガイドです。
はじめに: ロジックに存在しないバグ
あなたが持っている Python 少量のデータサンプルでは完璧に動作するが、不可解なエラーでクラッシュするスクリプト MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
これらの高レベルで予測不可能な問題の多くは、メモリに関するコンピュータサイエンスの基礎概念に根ざしています。これらを理解することは、単なる学問的な演習ではなく、より優れた信頼性の高いコードを書くための実践的なスキルです。この記事は、YouTubeで公開されているCS50x 2025(ハーバード大学)のメモリに関する講義を基にまとめたものです。
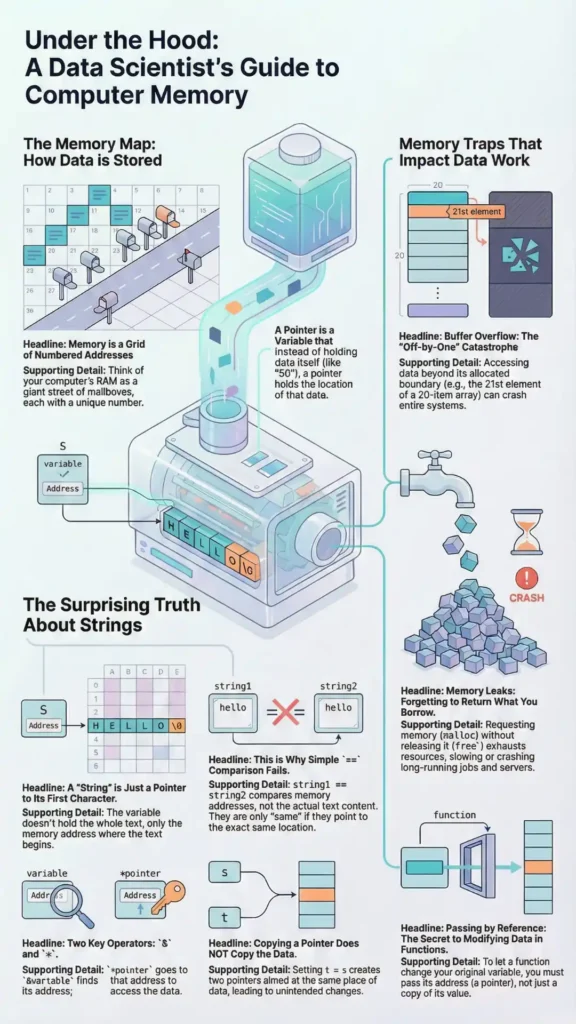
教訓1:「ひも」は幻想である
多くの入門的な文脈では、 string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
私たちが文字列と呼んでいるものは、実際には char *—a pointer to a character. This pointer is simply the memory address of the 最初の シーケンス内の文字。文字列の終わりを知るために、C言語では特別なセンチネル値、つまりヌル終端文字(\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
データサイエンスの接続: この概念は、Pythonのような高水準言語の祖先です R などの高水準言語が文字列やその他の可変長データを扱う方法の原点となっています。文字列操作が計算コストのかかる処理になる理由を説明するものであり、システムはしばしば終端点を探したり、基となる配列を管理したりしています。データサイエンティストにとって、これは生のテキストファイルを解析したり、APIを操作したりする際に非常に重要です。終端バイトが欠落していたり、間違っていたりすると、データが破損したり、解析エラーが発生したりする可能性があります。例えば、ログファイルの行が正しく読み取られず、重要なエラー情報が切り捨てられるといったことが考えられます。
教訓2: なぜ == Can Lie About Equality
C言語で2つの整数変数を比較する場合 ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory アドレス.
「high」と「high」という2つの同一の文字列があるが、メモリ内の異なる場所に格納されている場合、 == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
データサイエンスの接続: これはPythonにおけるオブジェクトの同一性と値の等価性の概念と直接的に類似しています。 is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
ポイント3:コピーは単なるエイリアスである可能性がある
C言語では、次のような命令は string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the 住所 文字列の最初の文字。
これは両方の変数を意味します。 s と t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
データサイエンスの接続: これは、Pandasユーザーをしばしば混乱させる「ビューとコピー」問題の根本原因です。データサイエンティストは、DataFrameをフィルタリングして新しい変数に代入し、独立したコピーを操作していると思い込んで変更を開始することがあります。しかし、Pandasが「ビュー」(元のデータを指すエイリアス)を返した場合、意図せず元のデータセットを変更していることになります。これは、別の場所で行われた操作によって元のデータが「不可解にも」変更されるため、追跡が困難な、微妙で危険なバグにつながる可能性があります。
「2つの文字列を比較するためにイコール演算子を使うと…つまり、2つのCharスターを比較するということです。つまり、2つのアドレスを比較するということです。明らかにそれらは異なる場所にあります…私たちはこれを解決する必要がありました。そこで、この問題を適切に解決する関数、stir compを導入しました。」— ハーバード大学CS50x 2025 (YouTube) — 講義:メモリ
ポイント4:記憶は管理しなければならない有限のリソースである
プログラムの実行中にメモリが必要な場合(例えばファイルから読み込んだデータを保存する場合など)、オペレーティングシステムにメモリを要求することができます。C言語では、これは関数によって行われます。 malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
ただし、この要求は失敗する可能性があります。システムの利用可能なメモリが不足している場合、 malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
データサイエンスの接続: これは大規模なデータセットを扱う場合に直接当てはまります。巨大なCSVファイルやParquetファイルをPandas DataFrameにロードしようとすると、システムが利用可能なメモリ量を超えるメモリを要求すると、スクリプトがクラッシュする可能性があります。 malloc と free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
教訓5: 関数にはプライベートワークスペースがある (The Stack)
関数が呼び出されると、「スタック」と呼ばれるメモリ領域に関数専用のワークスペースが作成されます。この「スタックフレーム」には、関数に渡された引数を含むローカル変数が保持されます。
CS50の講義では、これを次のように実証しています。 swap function intended to swap two integer values. The initial version fails because it only swaps コピー 関数のプライベートスタックフレーム内の値を渡します。これは「値渡し」と呼ばれます。関数が終了すると、そのスタックフレームは消え、呼び出し関数の元の変数(main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory アドレス 元の変数の。これにより、 swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
データサイエンスの接続: この概念は、データ変換関数を作成する際に、変数のスコープと可変性を理解する上で非常に重要です。関数が渡されたデータフレームを期待どおりに変更しない理由(例えば、オブジェクトを直接変更するのではなく、内部で変数を再割り当てする場合など)を説明するのに役立ちます。また、再現性、テスト可能性、バグのない分析パイプラインを作成するために不可欠な、「純粋関数」(入力値を変更しない関数)の設計原則を強調するものでもあります。
ポイント6:10億ドルのバグは「Off-by-One」エラー
「バッファオーバーフロー」は、プログラムがメモリバッファ(配列など)の割り当てられた境界を超えてデータを書き込もうとしたときに発生します。これは、1ガロンの水をパイントグラスに注ぐようなものです。余分な水はどこかに流れ込む必要があり、隣接するメモリを上書きしてしまうことが多く、破損やクラッシュを引き起こします。
この講義では、CrowdStrikeセキュリティソフトウェアが関与した実際のインシデントを取り上げています。アップデートのバグが原因で、世界中のシステムがダウンしました。根本原因は驚くほど単純でした。コードは20個の値を持つ配列を想定していましたが、実際には21個でした。存在しない21番目の要素にアクセスしようとしたため、「境界外メモリ読み取り」が発生し、システムクラッシュにつながりました。C言語にはこれに対する自動的な保護機能がないため、これは危険なバグの典型例となっています。
データサイエンスの接続: これは、データ処理における防御的プログラミングの究極の教訓です。ファイルの解析、リストの反復処理、APIレスポンスの処理を行う際、入力データが期待どおりであるとは限りません。この低レベルの脆弱性は、堅牢なエラー処理と入力検証の重要性を浮き彫りにします。予期しない値によってパイプライン全体がクラッシュするのを防ぐため、データ処理の前に、必ず想定されるフォーマット、サイズ、境界を明示的にチェックするようにしてください。
今日何を申請すべきか:実用的なチェックリスト
- 平等チェックを調査する: モデルやデータフレームのような複雑なオブジェクトを比較するときは、それらが正しいかどうかを確認する必要がある場合は一時停止して確認してください。 全く同じ物体 記憶(アイデンティティ)の中にあるか、それとも単に 同じデータが含まれている (等式)。適切な方法(
isvs..equals()) for your goal. - DataFrame の変更を監査します。 DataFrameのコピーと思われるものを変更する前に、それがビューなのかコピーなのかを明示的に確認してください。ビューへの単純な変更は、元のデータセットを気づかれずに破損させる可能性があります。
.copy()to ensure you have an independent object. - 記憶について積極的になる: 大きなファイルを扱うときは、ただ読み込んでうまくいくことを期待するのではなく、ツールを使って利用可能なシステムメモリを確認し、ファイルを小さなチャンクに分割して処理します(例:
chunksizeにpandas.read_csv) to avoid requesting more memory than is available. - データ境界の検証: リストや配列など、インデックスを使ってデータにアクセスする場合は、潜在的な障害発生点となることを念頭に置いてください。特にデータのサイズが外部ソースによって決定される場合は、インデックスが想定範囲内であることを確認するためのチェックを追加してください。
- 入力データを決して信頼しない: ファイル、API、またはユーザー入力から得られるデータは、根本的に信頼できないものとして扱います。操作を実行する前に、アサーションやデータ型、サイズ、形式に関する明示的なチェックを追加することで、予期しない問題が分析に支障をきたす前に発見できます。
9. 最後に
これらの低レベルメモリの概念は、単なる学術的な豆知識ではありません。高度なデータサイエンスの現場で遭遇するバグ、パフォーマンスのボトルネック、セキュリティリスクといった形で直接的に表面化します。メモリ内で何が起こっているかを理解することで、症状に戸惑うのではなく、根本原因を診断できるようになります。CS50コースが進むにつれて、これらの原則は、データベースやアルゴリズムを支える効率的なデータ構造を構築するための基盤となっていきます。
コード内の最近の「奇妙な」バグは、これらのコアメモリ原則の 1 つで説明できるでしょうか?


