


データ構造:データサイエンティストのためのガイド
この投稿は、データ実践者が基本的なデータ構造を理解し、より高速でメモリ効率の高いコードを作成するのに役立ちます。
データ処理スクリプトにおける一般的なボトルネック(特徴量エンジニアリングのループの遅延から非効率的な検索まで)は、多くの場合、タスクと使用されている基盤となるデータ構造の不一致に起因します。こうしたパフォーマンス上の問題点の根本原因は、多くの場合、コードのロジックではなく、データがメモリ内でどのように構成されているかにあります。こうした構造とそのトレードオフを理解することは、効率的でスケーラブルな分析パイプラインを作成するための基本的なスキルです。この記事では、ハーバード大学の著名なCS50xコースからデータ構造に関する重要な教訓を抽出し、これらのコンピュータサイエンスの基礎をデータ分析とデータサイエンスの実践世界に直接結び付けます。この記事は、YouTubeのCS50x 2025(ハーバード大学)に基づくものです。
1. 配列とその隠れたサイズ変更コスト
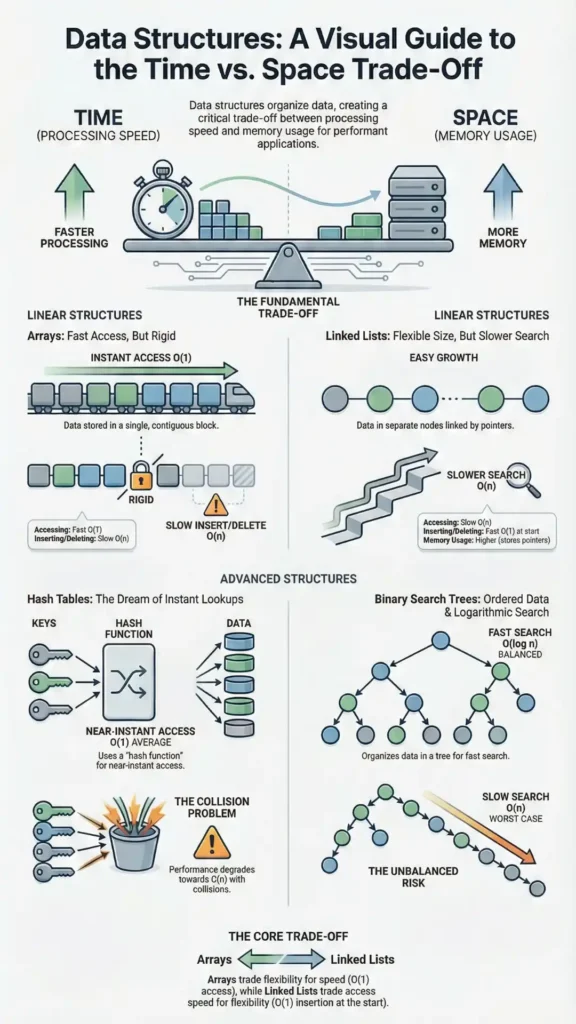
配列は、同じ型の要素がメモリ内に連続して(「連続して」)格納されるシンプルなデータ構造です。この連続したレイアウトにより、インデックスによる任意の要素へのアクセスが非常に高速になります。しかし、配列には重要な制限があります。それは、配列のサイズを事前に決めなければならないということです。
すでにいっぱいになっている配列を「拡張」する必要がある場合、どうなるでしょうか?メモリの末尾に既に要素がある場合、単純に新しい要素を追加することはできません。唯一の解決策は、完全に新しい、より大きなメモリブロックを割り当て、古い配列から新しい配列にすべての要素を手動でコピーし、元の配列で使用されていたメモリを解放することです。このコピー処理は時間のかかる「線形時間」の処理であり、配列が大きくなるほど時間がかかります。
データサイエンスコネクション
Pythonのリストなど、多くの一般的なデータツールは「動的配列」のように動作します。自動的にサイズが大きくなるように見えますが、実際には内部でコストのかかるサイズ変更が行われています。追加を高速化するために、Pythonのリストは余分な領域を確保する オーバーアロケーションを使用し、結果として追加は—余分なスペースを予約する—これにより 償却定数時間(償却O(1)) で実行できます。しかし、大きなリストの先頭に項目を挿入するのは、サイズ変更の可能性だけでなく、後続のすべての要素を右に1つずつ ずらす必要があるため、直接O(n)のコストがかかり、遅くなります。 右に1つの位置、直接O(n)コスト。
2. 連結リスト:連続したメモリを犠牲にして柔軟性を追求
リンクリストは、配列の厳格なサイズ変更問題を解決するソリューションを提供します。リンクリストでは、要素を連続的に格納するのではなく、メモリ内の任意の場所に配置できる「ノード」の連続として格納されます。各ノードには、データと、次のノードの位置を指す「ポインタ」(アドレス)の2つの要素が含まれます。これにより、必要に応じて利用可能なメモリ位置を「つなぎ合わせる」ことができます。
この構造により、主要なトレードオフが発生します。
- 逆さま: リストは既存の要素をすべて移動することなく、動的に拡大・縮小できます。これにより、断片化されたメモリをより効率的に利用できます。
- 欠点: 各要素ごとに次の要素のアドレスを格納するための追加のポインターが必要になるため、全体的にメモリ使用量が増加します。
- 重大な欠点: 高速な二分探索を実行できなくなります。要素が連続して格納されていないため、リストの中央に瞬時にジャンプすることはできません。リストの先頭からノードを一つずつ走査する必要があります。
データサイエンスコネクション
リアルタイムイベントログを考えてみましょう。更新に基づいてイベントをシーケンスの途中に挿入したり削除したりする必要がある場合があります。標準的なPython list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from 両言語で 終了します。
3. 直感に反する真実:最速リストは逆順に構築される
連結リストを扱う場合、新しい要素を追加する方法はパフォーマンスに大きな影響を与えます。リストの 先頭 に新しいノードを追加する(先頭に追加する)には、新しいノードを作成し、リストの先頭にあるいくつかのポインタを更新するだけで済みます。この操作はリストの全体サイズに依存しません。
これにより、先頭への追加は 定数時間 (O(1)) 操作となり、非常に高速になります。一方、リストの 末尾 に新しいノードを追加する(追記)には、まずリスト全体を先頭から走査して最後のノードを見つける必要があります。そのため、追記は linear time (O(n)) 操作となり、リストが大きくなるにつれて徐々に遅くなります。
驚くべきことに、リンクリストをゼロから構築する最も効率的な方法は、新しい要素を先頭に追加していくことです。つまり、1、2、3と順番に挿入していくと、メモリ上の最終的なリストは3 -> 2 -> 1となります。
データサイエンスコネクション
これは、一見単純な選択(先頭に追加するか後部に追加するか)が、パフォーマンスに大きく影響する(O(1) vs. O(n))ことを示す典型的な例です。これは、データクリーニングや特徴量エンジニアリングのスクリプトで日常的に使用する操作の時間計算量を理解することの重要性を浮き彫りにしています。実行速度の遅いループの裏には、最適化できる線形時間の処理が隠れている可能性があります。
4. 二分探索木:縮退する可能性のある高速探索
二分探索木(BST)は、ソート済み配列の高速検索機能と連結リストの動的なサイズ変更という、両方の長所を融合させようと試みます。BSTは、各ノードが最大2つの子ノードを持つノードツリーです。この構造は「二分探索特性」によって決まります。つまり、任意のノードについて、左のサブツリーのすべての値は小さくなり、右のサブツリーのすべての値は大きくなります。
この特性により、ツリーの左または右ポインタをたどるだけで二分探索が可能になり、平均的に効率的な 対数時間 (O(log n)) の 探索性能を実現します。しかし、BST には重大な欠陥があります。既にソートされたデータを挿入する「異常なケース (たとえば、1、次に 2、次に 3、次に 4 を挿入する場合) では、ツリーは完全に不均衡になります。新しいノードは、前のノードの右側に単純に追加されます。
この最悪のシナリオでは、二分探索木は「連結リストに退化する」。その検索性能は対数時間から遅い linear time (O(n)).
データサイエンスコネクション
アンバランスBSTは、平均的なケースと最悪のケースのパフォーマンスの違いを力強く表現するメタファーです。データサイエンスにおいて、入力データの分布と順序はアルゴリズムの効率に劇的な影響を与える可能性があります。そのため、多くの場合ツリー構造に基づいているデータベースインデックスは、複雑な「バランス調整」アルゴリズムによって継続的に自己再構成し、最悪のシナリオの発生を防いでいます。
5. ハッシュテーブル:定数時間への実用的な道
ハッシュテーブルは、キーと値のペアを格納する辞書を実装するための定番のデータ構造です。配列と連結リストを巧みに組み合わせることで、ほぼ瞬時の検索を実現します。そのコアコンポーネントは以下のとおりです。
- An 配列 「バケツ」の。
- A ハッシュ関数 キー (人の名前など) を受け取り、それを決定論的に配列のインデックスに変換します。
- リンクされたリスト 各バケット内で「衝突」(2 つの異なるキーが同じ配列インデックスにハッシュされる場合)を処理します。
講義で使われた Sweetgreen のピックアップ棚のアナロジーは、これを完璧に説明しています。注文書に書かれたあなたの名前が キーです。棚を選ぶためにあなたの名前の最初の文字 (AE、FJ など) を見る従業員が ハッシュ関数です。棚自体は バケット (配列のインデックス) です。その棚にある数種類のサラダをスキャンして探すことが、衝突を処理するための リンク リスト を表します。理論上の最悪のケースは、すべてのキーが 1 つの長いリンク リストに衝突する場合 linear time (O(n)) すべてのキーが1つの長いリンクリストに衝突する場合、実際の平均ケースのパフォーマンスは驚くほど近いです。 定数時間 (O(1)).
「はい、ハッシュテーブルは技術的にはN/Kで、これはnのBig Oに相当します。しかし、実際には賢く、使用するハッシュ関数を巧みに使いこなせば…衝突の確率は非常に低くなるため、時折線形時間になるとしても、ほとんどの場合は定数時間、つまり1のBig Oになるでしょう。」— ハーバード大学CS50x 2025 (YouTube) — 講義:データ構造
データサイエンスコネクション
ハッシュテーブルはPythonの辞書の背後にあるエンジンです(dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
今日何を申請するか
- キーと値の参照には常に辞書/ハッシュマップを使用する ペアのリストを検索するよりも、O(1)とO(n)のパフォーマンス差は、大規模なデータセットでは極めて大きくなります。
- パフォーマンスが重要な場合は、データの順序に注意してください。 バイナリ検索ツリーの場合と同様に、ソートされたデータを特定の構造に挿入すると、最悪の動作が引き起こされる可能性があります。
- データを整理する必要があるかどうかを質問します。 高速な検索とメンバーシップ テストだけが必要な場合は、セット (ハッシュ ベース) の方がリストよりもはるかに効率的です。
- 基礎となる操作を視覚化します。 スクリプトが遅い場合は、ループ内で線形 O(n) 操作を強制して、意図せず O(n²) の複雑さを生み出していないか検討してください。
- 時間と空間のトレードオフを認識します。 ハッシュテーブル(Pythonのような
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
閉鎖
中心となるテーマは、あらゆるデータ構造が時間、メモリ、実装の複雑さの間でトレードオフを生じているということです。「最良」の構造は一つではなく、タスクに最も適した構造があるだけです。講義は次にPythonに移ります。Pythonは、これまで議論してきた多くの手動メモリ管理の詳細を抽象化する言語です。しかし、これらの構造は依然として内部で動作しているため、パフォーマンスの原則は依然として重要です。毎日使っているどのデータ構造について、あなたは考え方を変えるでしょうか?


