


AIの本当の仕組みを学ぶコンピュータサイエンスのレッスン
データ アナリストや科学者にとって、ハーバード大学の CS 講義を分解したこの資料は、コンピューター サイエンスの理論を日常業務に役立つ実用的な知識に変えてくれます。
はじめに:「ただ機能する」ことの隠れたコスト
モデルの出力がおかしくなったり、関係者に「ブラックボックス」な予測を説明したりするのに苦労したことはありませんか?データサイエンスでは、一見「普通に使える」ように見える強力なツールを使うことがよくあります。しかし、実際にはそうではありません。予期せぬ結果に苛立ちを覚えるのは、ツールの使い方と基本原理の理解との間にギャップがあることが多いのです。現代のデータの問題をコアコンピュータサイエンスの視点から見ることで、ツールを単に使うだけでなく、自信と明快さを持って使いこなせるようになります。この記事は、YouTubeで視聴できるCS50x 2025(ハーバード大学)の人工知能に関する講義を基にまとめたものです。講義の内容を5つの具体的なポイントに凝縮し、コンピュータサイエンスの理論とデータ活用の実際を結び付けることで、すぐに応用できる効果的な概念を習得できます。
ポイント1:AIは単純なルールから複雑な確率まで幅広い範囲をカバー
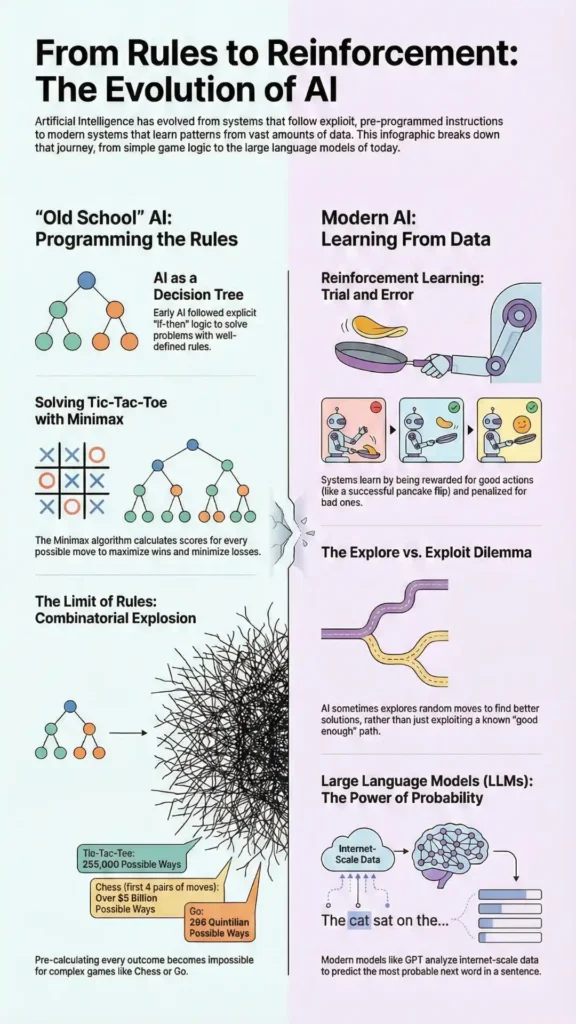
人工知能は一枚岩ではなく、スペクトルです。一方の端には、単純で決定論的なシステムがあります。講義では、三目並べを典型的な例として用います。このゲームの「AI」は、 決定木—一連の if-else rules—and an algorithm called ミニマックスこのアルゴリズムは盤面にスコア(例えば、勝ちなら+1、負けなら-1、引き分けなら0)を割り当て、逆算して自身にとって最良の結果をもたらす手を選択します。このアプローチは網羅的であり、勝ちか引き分けを保証します。しかし、このルールベースのロジックは、非常に制約の厳しい環境でのみ実現可能です。講義で指摘されているように、チェスのようなより複雑なゲームでは、最初の4組の手だけでも850億通り以上の方法があり、完全な決定木を計算的に構築することは不可能です。
スペクトルの対極に位置するのが、大規模言語モデル(LLM)のような現代的な確率的システムです。これらのモデルは明示的な規則には従いません。講義で説明されているように、トレーニングデータから学習した膨大なパターンと頻度に基づいて、単語列の中で最も可能性の高い次の単語を予測することで機能します。つまり、確実性ではなく、尤度に基づいて動作するのです。
データサイエンスの接続: このスペクトルは、一般的なデータサイエンスのアプローチに直接対応しています。SQLで明示的なビジネスルールを記述すると、例えば CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
ポイント2:「プロンプトエンジニアリング」とは、構造化されたコンテキストに過ぎない
話題の「プロンプトエンジニアリング」というスキルは、難解なコマンドよりも、構造化されたコンテキストを提供することに重点が置かれています。この講義では、CS50のラバーダックAIアシスタントを完璧な例として、この点を分かりやすく解説します。プロンプトには、 システムプロンプト といった ユーザープロンプトという2つの重要な部分があります。ユーザープロンプトは、単に人が尋ねる質問です。開発者が作成するシステムプロンプトは、AIがどのように動作し、どのような制約に従うべきかを指示する一連の命令です。
CS50チームは、アヒルに非常に具体的なシステムプロンプトを与え、一般的な法学修士課程の生徒の行動を、役に立つけれども不正行為をしないティーチングアシスタントへと変化させました。その指示には、次のような直接的なコマンドが含まれていました。
「あなたは cs50 のフレンドリーで協力的なティーチングアシスタントです。」
「あなたもゴム製のアヒルよ。」
「学術的誠実性に反するため、問題に対する完全な回答は提供しないでください。」
これらの指示は、AI が単なるデフォルトの回答ではなく、有用でドメイン固有の安全な応答を生成するために必要なコンテキストを提供します。
データサイエンスの接続: これは、あらゆるデータ分析プロジェクトの範囲と制約を定義することと直接的に類似しています。分析のための適切な「システムプロンプト」は、AIではなく、あなた自身と関係者に与えられるものです。これには、主要なビジネス用語の定義(「アクティブユーザー」とは具体的に何を指すのか?)、日付範囲の指定、または解決しようとしている主要なビジネス上の質問の提示などが含まれます。この初期設定を行うことで、無駄な労力や誤解を防ぎ、最終的な分析が適切かつ正確であることを保証します。
ポイント3:重要なトレードオフ:探索 vs. 搾取
人工知能における最も強力な概念の一つは、探索と活用のジレンマです。この講義では、AIエージェントが溶岩の穴を避けながら緑色の出口を見つけなければならない単純な迷路ゲームを用いて、このジレンマを説明します。エージェントは最初は偶然正しい経路を見つけ a 強化学習によってそれを繰り返したどることを学習します。これが 活用、つまり既知の情報を用いて確実な結果を得ることです。
しかし、最初の経路が必ずしも 最高 経路とは限りません。より最適で短い経路を見つけるために、AIは講義で「イプシロン値」として定義される少量のランダム性を導入する必要があります。これは、エージェントが学習した最良の行動ではなく、ランダムな行動をとる確率(例えば5%または10%)を表します。これにより、 探索行動が促されます。たとえ溶岩の穴に落ちるなど、短期的な失敗のリスクがあっても、新しいランダムな行動を試みるのです。時間をかけて、このわずかな探索の機会によって、AIはより優れた戦略を発見できるようになります。
この原理は、AIがブレイクアウトというゲームのプレイ方法を学習する例で力強く実証されました。純粋なエクスプロイトでは、AIはパドルを前後に動かすだけです。しかし、探索によって、AIは直感に反しながらも非常に効果的な戦略を発見しました。ボールを片側にトンネル状に押し込む戦略です。これにより、ゲームは実質的に「自動的にプレイ」し、膨大なスコアを獲得することができました。
データサイエンスの接続: このトレードオフは、データサイエンスの作業において中心的な役割を果たします。A/Bテストは、このトレードオフを形式的に表したものです。既知の勝者(活用)を使い続けながら、新しいバリエーションをテストして、それがより優れているかどうかを確認します(探索)。これはモデルの最適化にも当てはまります。既に十分な性能を発揮しているハイパーパラメータに固執するのではなく、新しいハイパーパラメータを試してみるかもしれません。キャリア開発にも当てはまります。使い慣れたツール(活用)を使い続けるか、より強力な新しい言語やフレームワークを学ぶ時間を取るか(探索)?
ポイント4:LLMは抽象的思考者ではなく、パターンマッチングの達人である
講義によると、大規模言語モデル(LLM)は人間の意味での推論や「思考」ではなく、非常に洗練されたパターンマッチングシステムです。ニューラルネットワーク上に構築されたLLMは、インターネット上の膨大な量のテキストで事前学習されています。その中心的な機能は、ある単語列の直前の単語に基づいて、その単語列の中で最も可能性の高い次の単語を計算することです。
講義では簡潔にこう述べられています。「…もし誰かが「調子はどう?」と聞いてきたら、このデータすべてに基づく確率論的に、PTまたはcs50のダックが99%の確率で「元気だよ、ありがとう、調子はどう?」と返事するはずです。」モデルは調子が悪いのではなく、トレーニングデータに基づいて統計的に最も可能性の高い応答を生成しているだけなのです。
この確率的な性質は、の直接的な原因です この確率的な性質こそが、幻覚の直接的な原因である。LLMが事実と異なることを自信満々に述べるのは、その学習データにおけるパターンが、誤った記述がもっともらしく聞こえる単語の羅列であることを示唆しているからである。LLMは事実を検証しているのではなく、統計的に可能性の高い文を組み立てているのだ。
データサイエンスの接続: これはデータ専門家にとって重大な意味を持ちます。LLMの出力は決して真実として扱うべきではありません。むしろ、一次情報源との照合が必要な、十分に練られた仮説として捉えるべきです。このような批判的な考え方は、分析の厳密性を維持するために不可欠です。検証せずにLLMの出力を使用すると、レポート、ダッシュボード、モデルに誤った情報が拡散し、あなたの仕事に対する信頼が損なわれるリスクがあります。
ポイント5:真のAIソリューションは単なるモデルではなくシステムである
有用なAIツールは、単なるスタンドアロンのモデルで完結することは稀です。そのモデルを中心に構築されたシステム全体です。この講義では、この点を的確に表すCS50ダックデバッガーの「アーキテクチャ図」が紹介されています。CS50チームは独自のLLMをゼロから構築したのではなく、複数の主要コンポーネントを統合することで、価値あるツールを開発しました。
このシステムには、学生にとって使いやすいインターフェース、講義内容の書き起こしを保存・検索するためのローカル ベクトルデータベース 、そしてOpenAIなどのプロバイダーからのサードパーティ API への接続機能が含まれています。チームの主な功績は、新たな基礎モデルを構築したことではなく、これらの要素を組み合わせて、特定の教育上の問題を効果的に解決するシステムを構築したことにあります。
データサイエンスの接続: これはデータサイエンティストにとって非常に重要な教訓であり、「モデルを構築する」という考え方から「データ駆動型ソリューションを設計する」という考え方への転換が求められます。どんなに複雑なモデルであっても、真のビジネス価値は単体のモデルにあることは稀です。真の価値はシステム、つまりモデルにデータを供給するデータパイプライン、予測結果を提供するAPI、そしてモデルを使いやすくするインターフェースにあります。アーキテクトのように考えるということは、アルゴリズムの最適化から、問題解決のための完全なシステムの設計へと焦点を広げることを意味します。
今日何を申請するか
- 次のプロジェクトのための「システムプロンプト」を作成します。 コードを書く前に、CS50 ダックのプロンプトと同じように、目標、制約、主要な定義を定義する段落を記述します。
- 探索と搾取を識別する: 現在の仕事の中で、既知のプロセスを「活用」している領域を一つ見つけてみましょう。小規模な「探索的」実験とはどのようなものになるか考えてみましょう。
- 問題を意思決定ツリーにマッピングする: ホワイトボードを使って簡単なビジネス問題を
if-then-elselogic of a decision tree. Does this clarify the logic? - 信頼するのではなく、検証する: 生成AIから得られる次の情報を仮説として扱い、3分かけて一次情報源から検証してみましょう。
- システムで考える: モデルを構築する際には、必要な入力と生成される出力を簡潔に図示します。人や他のシステムは、どのようにモデルを使用するのでしょうか?
終わりに:コードから認知へ
AIの背後にあるコンピュータサイエンスの基本原理を理解することは、テクノロジーの神秘性を解き明かすだけでなく、制御、明確化、そして批判的思考のための枠組みを与えてくれます。決定木、確率的推論、探索と活用のトレードオフといった概念は、抽象的な理論ではなく、より堅牢で信頼性の高いデータソリューションを構築するための実践的なツールです。これらの概念は、より高度なトピックへの理解を深めるための基盤となります。これらの確率システムが私たちのツールにさらに統合されるにつれて、分析の真実性を確保するために、私たちはどのように独自の手法を適応させる必要があるのでしょうか?





