


データクエリにおけるSQLの利点
このガイドでは、データ アナリストとデータ サイエンティストに、SQL の基本原則を使用して、汎用 Python スクリプトよりも高速で堅牢かつ保守しやすいデータ パイプラインを構築する方法を説明します。
はじめに:「ただループするだけ」の隠れたコスト
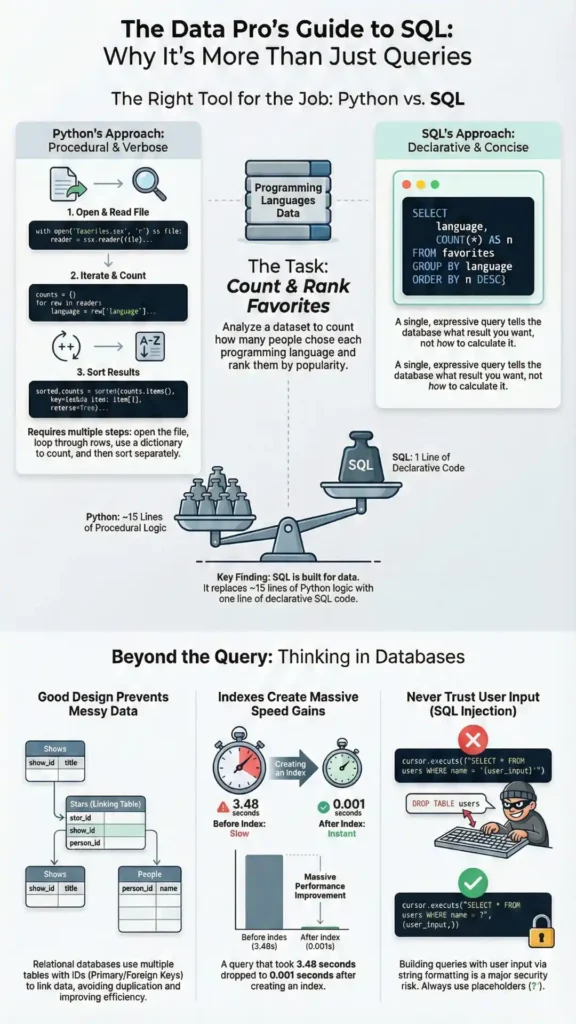
多くのデータ実務家にとって、新しいCSVファイルへのデフォルトのアプローチは、Pythonスクリプトを作成することです。ファイルを開き、行をループ処理し、一見単純な質問に答えるために、手動でカウンターやリストを作成します。この方法は確かに機能しますが、多くの場合、遅くて脆弱なコードになり、メンテナンスが困難になります。ソースファイル内のいくつかの列の順序が変更されただけで、スクリプト全体が壊れてしまう可能性があります。わずかに異なる質問に答えるには、複雑なループや条件文を書き直す必要があります。この命令型のステップバイステップのアプローチの裏には、より強力で、エレガントで、効率的なデータ処理方法が隠されています。専用の言語を採用することで、複雑な質問をより簡単に表現できるようになり、17行もの脆弱なPythonコードを、宣言型のSQLコード1行に置き換えることができます。
ポイント1:データ取り込みを堅牢にする
単純なPythonデータスクリプトにおける最も一般的な脆弱性の1つは、数値インデックスでCSV列にアクセスすることです。 row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
より堅牢な解決策は、Pythonの組み込み csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
データサイエンスの接続: この手法により、データ取り込みパイプラインはソースファイルの変更に対して大幅に耐性が向上します。予期せぬバグの発生を減らし、メンテナンスを最小限に抑え、分析結果が正しいデータ列に基づいていることを保証することで、ワークフロー全体の信頼性が向上します。
教訓2:宣言的な考え方の転換
PythonとSQLの根本的な違いは、それらが推奨するプログラミングパラダイムです。Pythonは主に 命令的—コンピュータに伝える どのように 答えをステップバイステップで得ることができます。CSVからお気に入りのプログラミング言語をカウントするには、Pythonのアプローチでは、カウンタ変数を初期化し、ファイルを開き、各行をループし、 if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
対照的にSQLは 宣言的—あなたは宣言する 何 必要な答えをデータベースエンジンが見つけ出し、最も効率的な方法でそれを取得します。SQLでは、同じカウントタスクは1つの文で実行されます。 SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
データサイエンスの接続: 宣言的な思考を用いることで、アナリストは複雑なデータに関する質問をより直接的に、論理的な誤りの余地を少なく表現できるようになります。複雑な手続き型ループを構築する代わりに、必要なデータの定義に集中できるため、より簡潔で読みやすく、より正確なクエリを作成できます。
「…このコードを簡単にできればいいのに、構築にかなりの時間を費やしているように感じます…その質問に非常に早く答えられたらいいのですが…」 — ハーバード CS50x 2025 (YouTube) — 講義: SQL
ポイント3: 適切なデータ形状は偶然ではない
データの構造は、それを正確かつ効率的に分析する能力に劇的な影響を与えます。テレビ番組「The Office」のスプレッドシートでよく見られるミスは、関連データを不適切に保存することです。例えば、星ごとに新しい列を追加するといった設計ミスが挙げられます(star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
解決策は、コアデータベースコンセプトと呼ばれるものです。 正規化乱雑な1つのテーブルではなく、データを個別のエンティティごとに別々のテーブルに分割します。例えば、 shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id と person_id).
この設計では、「The Office」のような長くて可変長のテキスト文字列を、小さな固定サイズの整数(例:32ビットまたは64ビットのID)に置き換えることで冗長性を排除します。このアプローチにより、大幅なスペース節約とパフォーマンス向上が実現します。
データサイエンスの接続: 正規化は、データのクリーニングと構造化のための強力な思考モデルを提供します。スプレッドシートなどの乱雑なデータセットにおける冗長性を認識して修正することで、分析エラーを防ぎ、集計や結合が正しい結果を生み出すことを保証します。これは、信頼性の高い分析のためにデータを準備する上での基礎となるステップです。
ポイント4:ワンラインパフォーマンス修正
遅いクエリはデータ分析における大きなボトルネックであり、特に複雑な関係を持つ大規模なデータセットでは顕著です。例えば、3つのテーブルを結合してスティーブ・カレルのテレビ番組をすべて検索するクエリは、講義の中で実行に3.483秒という「うんざりするほど長い」時間を要しました。この遅延は、指示がない場合、データベースが線形検索、つまりテーブル内のすべての行をチェックして一致するものを探すために発生します。
解決策は、 INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
トレードオフとして、インデックスはより多くのストレージスペースを消費し、書き込み操作がわずかに遅くなる可能性がある(INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
データサイエンスの接続: インデックスを理解することで、データ実務者はパフォーマンスのボトルネックを解消するためのシンプルかつ効果的なツールを手に入れることができます。大規模なデータセットに対するクエリの実行速度が遅い場合、フィルタリングされた列にインデックスを作成することが、多くの場合、最初に行うべき最も効果的な最適化手順となります。
ポイント5:ユーザー入力を信用するのをやめる
例えばPythonのf文字列などを用いて、ユーザー入力を文字列に直接挿入してクエリを構築すると、 SQLインジェクション攻撃と呼ばれる深刻なセキュリティ脆弱性が発生します。これは、悪意のあるユーザーが入力した内容がSQLコマンドの一部として実行される場合に発生します。
典型的な例としてはログインフォームがあります。コードが次のようなクエリを作成すると、 f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
解決策は、 常に つかいます パラメータ化されたクエリf文字列の代わりにプレースホルダー( ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
データサイエンスの接続: これは、インタラクティブなデータアプリケーション、ダッシュボード、またはユーザーが指定したフィルターや入力に基づいてデータベースにクエリを実行するツールを構築するすべての人にとって、非常に重要なセキュリティ対策です。クエリをパラメータ化しないと、データとシステムが重大なリスクにさらされます。
今日何を申請するか
- PythonでCSVを読み込む場合は、
csv.DictReaderinstead of accessing columns by number. - データを集計するPythonループを書く前に、「これは単一の
GROUP BYquery in SQL?” - スプレッドシート内で同じテキスト値が何度も繰り返される場合は、一意の ID でリンクされた 2 つのテーブルにデータを分割することを検討してください。
- もし
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - SQLクエリにユーザー入力を追加する際は、f文字列や文字列連結を使用しないでください。必ずプレースホルダーを使用してください。
閉鎖
Pythonのような汎用言語をあらゆるタスクに利用するのは簡単ですが、CS50のこの講義では、コンピュータサイエンスの基礎概念がデータ処理において強力かつ実用的なメリットをもたらすことを実証します。この講義は、コンピューティングの基礎となるトピックがデータ分析の品質と効率をどのように直接的に向上させるかを示す包括的なシリーズの一部にすぎません。SQLの宣言型の性質、適切なデータモデリング原則、そしてパフォーマンス機能を活用することで、データ実務者はより高速で、より堅牢で理解しやすいコードを作成できます。
Pythonで日常的に行っているデータ処理作業の中で、代わりに単一の 宣言型SQL クエリで済ませられるものは何ですか?





