R を使用したロジスティック回帰: 決定版ガイド
予測分析とデータ駆動型の意思決定において R を使用したロジスティック回帰の極めて重要な役割を学びます。
イントロダクション
データサイエンスというダイナミックな分野において、ロジスティック回帰二値分類問題に対する重要なツールであり、予測モデリングを通じてデータに関する深い洞察を提供します。この統計的手法は、特に統計分析とモデリング機能で定評のある多機能ツールであるRと組み合わせることで、アナリストや研究者が隠れたパターンを発見し、情報に基づいた意思決定を行うことを可能にします。ロジスティック回帰と R の相乗効果により、実務者は複雑なデータ課題に取り組むための強固なフレームワークを手に入れ、データ駆動型イノベーションと戦略的洞察の基盤を築くことができます。本書は、Rを用いたロジスティック回帰の習得への道筋を示し、読者がこの強力な分析手法の可能性を最大限に引き出すための知識を身につけられるよう解説します。
ハイライト
- R は複雑なロジスティック回帰モデルを簡素化し、予測精度を高めます。
- R のロジスティック回帰は、バイナリ結果を効率的に区別するのに役立ちます。
- R でのデータの前処理により、ロジスティック回帰モデルの信頼性が高まります。
- R の構文により、ロジスティック回帰分析の直感的な実装が容易になります。
- 実際の例は、R を使用したロジスティック回帰の実際的な価値を示しています。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
ロジスティック回帰について
ロジスティック回帰はデータサイエンスの基礎となる手法であり、特にスパムか否か、勝敗、健康か病気かといった二値的な結果を伴う分類問題を解決する際に有効です。連続的な範囲で結果を予測する線形回帰とは異なり、ロジスティック回帰、特定の特徴量または入力が特定のカテゴリに分類される確率スコアを提供します。そのため、医学における疾病発生確率の予測、金融における債務不履行確率の予測、マーケティングにおける顧客行動の予測など、様々な分野で非常に重宝されています。
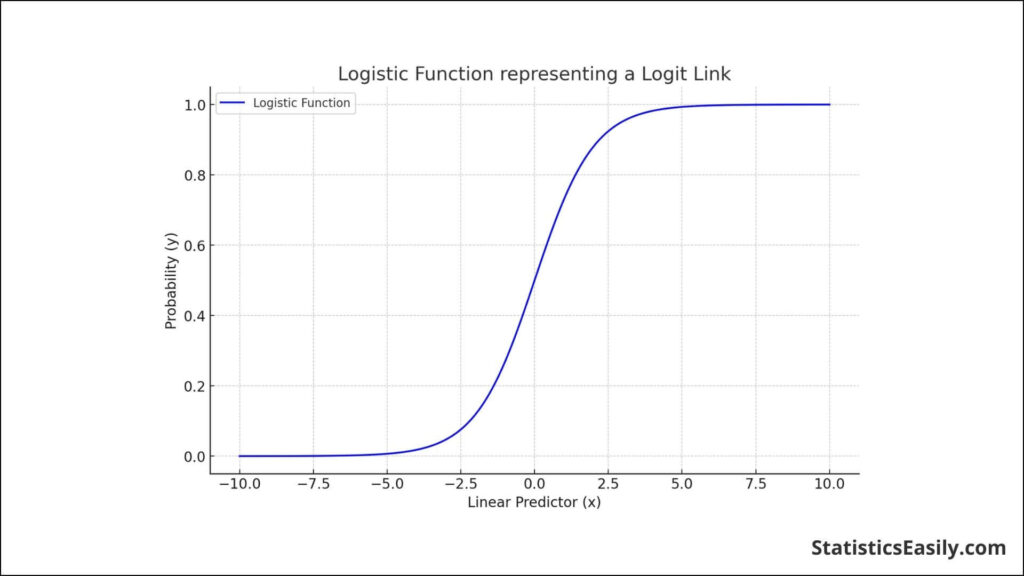
ロジスティック回帰の数学的基礎は、シグモイド関数と呼ばれることが多いロジスティック関数にあります。この S 字型曲線は、任意の実数値を 0 から 1 までの値にマッピングできるため、バイナリ分類タスクでの確率スコアのモデル化に最適です。ロジスティック回帰の方程式は、主に従属変数をモデル化するためにロジスティック関数を使用する点で線形回帰の方程式と対照的です。したがって、ロジスティック回帰モデルは、特定の入力ポイントが特定のクラスに属する確率を推定します。これは数学的に次のように表現できます。
P(Y=1∣X)=1/1+e−(β0+β1X)
ここで、 P(Y=1|X) は独立変数 X が与えられた場合に従属変数 Y が 1 になる確率、 e は自然対数の底、 β0 は切片項、 β1 は従属変数に影響を与える独立変数の係数を表します。
Rでは、ロジスティック回帰は「glm()」(一般化線形モデル)などの関数を使用して実装できます。familyをbinomialに設定することで、二項ロジスティック回帰であることを指定できます。この実装の簡便さと、Rの包括的なデータ操作および分析ツールセットを組み合わせることで、Rを使用したロジスティック回帰は予測モデリングのための強力なアプローチとなります。Rの機能を活用することで、データサイエンティストは比較的容易にデータの前処理、ロジスティック回帰モデルの構築、パフォーマンスの評価、および予測への利用を行うことができ、 データ分析 and modeling.
R入門
統計計算とグラフィックスで高く評価されている言語および環境であるRを使い始めるには、まず必要な基礎を準備することから始めます。初心者にとって最初のステップはRのインストールです。Rのインストールは簡単で、Comprehensive R Archive Network(CRAN)から入手できます。Rに加えて、直感的なインターフェースと追加機能でRのユーザーエクスペリエンスを向上させる強力なIDEであるRStudioをインストールすることを強くお勧めします。
インストール時に、実際のデータ分析を行うには、R の構文に慣れることが最も重要です。 R の構文はユニークでありながら直感的であり、ユーザーは簡潔なコードで複雑なデータ操作や分析を実行できます。主要な概念には次のようなものがあります。
- 変数とデータ型:R の変数とさまざまなデータ型 (数値、文字、論理など) に値を割り当てる方法を理解します。
- ベクトルとデータ フレーム:R でのデータ分析のバックボーンであるベクトルとデータ フレームの作成と操作を理解します。
- 関数とパッケージ:組み込み関数の使用方法、パッケージのインストールとロード方法を学び、基本機能をはるかに超えて R の機能を拡張します。 「glmnet」や「caret」などのパッケージは、ロジスティック回帰に非常に役立ちます。
- 制御構造:if-else ステートメントやループなどの制御構造を学び、スクリプトの実行フローを制御できるようにします。
R の構文の実際の動作を示す単純かつわかりやすい例は、次のようなデータ フレームの作成と操作です。
# Create a data frame
my_data <- data.frame(
  Outcome = c("Success", "Fail", "Success", "Fail"),
  Age = c(22, 45, 33, 29),
  Score = c(85, 47, 76, 62)
)

# View the data frame
print(my_data)

# Calculate the mean Score
mean_score <- mean(my_data$Score)
print(paste("Average Score:", mean_score))
このスニペットは、変数の割り当て、データ フレームの作成、および主な関数の使用法を示しています。 R の強力なツール スイートとデータ操作と分析への包括的なアプローチにより、R はデータ サイエンティストと統計学者の両方にとって不可欠なスキルとなっています。
ロジスティック回帰のためのデータの準備
ロジスティック回帰をRで適用する前の重要なステップは,R言語でロジスティック回帰を適用する前に、データのクリーニングと前処理を行うことが非常に重要です。このプロセスにより、データセットが正しくフォーマットされ、エラーや不要な情報が含まれておらず、ロジスティック回帰モデルのパフォーマンスと精度を高めるように構造化されていることが保証されます。
データクリーニングには、いくつかの重要な作業が含まれます。
- 欠損値の処理:「na.omit()」などの関数を使用してマウス パッケージから削除するか、「impute()」を使用して欠損値を推定値で埋めます。
- 外れ値の削除:外れ値により結果が歪む可能性があります。四分位範囲 (IQR) 法のような手法は、これらの異常を特定して除去するのに役立ちます。
- データの一貫性の確保:不一致を避けるために、日付形式やカテゴリ値などのデータの形式を標準化します。
データ前処理以下が含まれます。
- 変数の選択:予測された結果に最も関連する変数を特定します。これには、相関分析やドメインの専門知識などの統計手法が必要となる場合があります。
- データ変換:ロジスティック回帰には数値入力が必要なため、「factor()」や「model.matrix()」などの関数を使用してカテゴリ変数をダミー変数または因子に変換します。
- 機能のスケーリング:ロジスティック回帰には必ずしも必要ではありませんが、スケーリング関数を使用して特徴を標準化すると、モデルのパフォーマンスが向上する場合があります。
データを準備する具体的な例には、カテゴリ変数をロジスティック回帰に適した形式に変換することが含まれる場合があります。
# Assuming 'Gender' is a categorical variable with levels 'Male' and 'Female'
my_data$Gender <- factor(my_data$Gender, levels = c("Male", "Female"))

# Transforming 'Gender' into a dummy variable
my_data <- model.matrix(~ Gender + Age + Score - 1, data = my_data)
このスニペットは、ロジスティック回帰用のデータを準備する際の標準ステップである、「性別」カテゴリ変数をダミー変数に変換する方法を示しています。これにより、モデルにこの情報を効果的に組み込むことができます。
The 適切な変数を選択することの重要性は、いくら強調してもしすぎることはありません。結果を強く予測する変数を含めることでモデルの精度を高めることができますが、無関係な変数を含めるとモデルの予測力が弱まる可能性があります。重要な予測因子を特定するには、後方消去法、前方選択法、あるいはランダムフォレストのような機械学習アルゴリズムなどの手法を用いることができます。
要約すると、慎重にデータを準備することで、堅牢なロジスティック回帰モデルへの道が開かれます。データセットへの理解が深まり、より洞察力があり、影響力のあるデータ分析が可能になります。
R を使用したロジスティック回帰の実装
R でロジスティック回帰を実装するには、明確で構造化されたアプローチが必要です。このセクションでは、わかりやすくするためのコード スニペットを含め、ロジスティック回帰を実行する手順を説明します。モデルを構築し、その出力を解釈し、係数とモデルの適合性の重要性を理解する方法に焦点を当てます。
ステップバイステップガイド
1. 必要なパッケージの読み込み:ロジスティック回帰を実行するには、Rにプリインストールされている「stats」パッケージがインストールされていることを確認してください。このパッケージには、ロジスティック回帰に不可欠な「glm()」関数が含まれています。
# Ensure the stats package is loaded (it should be by default)
library(stats)
2. ロジスティック回帰モデルの構築:'glm()' 関数を使用し、二項分布族を指定してロジスティック回帰を実行します。'my_data' をデータセット、'Outcome' を二値の従属変数、'Predictor1' と 'Predictor2' を独立変数とします。
# Building the logistic regression model as before
logistic_model <- glm(Outcome ~ Predictor1 + Predictor2, family = binomial, data = my_data)

# Performing a Likelihood Ratio Test
anova(logistic_model, test = "Chisq")
3. モデルの要約:モデルの係数とその有意性を理解するには、「summary()」関数を使用します。
# Summarizing the logistic regression model
summary(logistic_model)
出力の解釈
- 係数:概要出力は、各予測子の係数を提供します。これらの係数は、結果変数の対数オッズを表します。正の係数は、予測変数が増加するにつれて、結果が発生する対数オッズが増加し、イベントの可能性が高くなることを示します。
- 有意水準:概要出力の「Pr(>|z|)」列を見てください。ここでの値は、各係数の p 値を表します。通常、0.05 未満の p 値は、予測変数が結果変数と有意に関連していることを示します。
- モデル適合:概要には適合度の尺度も含まれています。ヌル逸脱度と残差逸脱度は、モデルがデータにどの程度適合しているかを示します。ヌル逸脱と比較して残差逸脱が低い場合は、適合が良好であることを示します。さらに、Akaike Information Criterion (AIC) はモデルの品質を測定します。AIC が低いほど、モデルが過剰適合せずにデータによく適合していることを示します。
例の概要の解釈
ロジスティック回帰の要約からの以下の出力スニペットを考えてみましょう。
Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -1.2345     0.2079  -5.939  3.00e-09 ***
Predictor1     0.4456     0.1102   4.045  5.25e-05 ***
Predictor2    -0.5678     0.1456  -3.900  9.68e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 234.83  on 170  degrees of freedom
Residual deviance: 144.57  on 168  degrees of freedom
AIC: 150.57
- 「切片」と「予測子 1」および「予測子 2」は有意です (p < 0.05)。
- 「Predictor1」には正の係数があり、「Predictor1」を増やすと結果の対数オッズが増加することを示唆しています。
- 「Predictor2」には負の係数があり、「Predictor2」が増加すると結果の対数オッズが減少することを示します。
- 逸脱度と AIC 値の大幅な低下は、モデルの適合性が良好であることを示唆しています。
これらの手順に従い、モデルの出力を理解することで、R でロジスティック回帰を効果的に実装し、洞察力に富んだデータ分析と予測モデリングへの道を開くことができます。
R を使用したロジスティック回帰の強化
R でロジスティック回帰モデルの精度と予測力を向上させるには、慎重な特徴選択から高度なモデル評価手法まで、いくつかの戦略的な手順が必要です。ロジスティック回帰モデルを強化するためのヒントと方法をいくつか紹介します。
特徴の選択と変換
1. 変数の重要度:ステップワイズ回帰や機械学習アルゴリズム(例:ランダムフォレスト)などの手法を用いて、モデルにとって最も予測力の高い特徴量を特定します。これにより、重要な予測因子のみを残すことでモデルを簡素化できます。
library(MASS)
stepwise_model <- stepAIC(logistic_model, direction = "both")
summary(stepwise_model)
2. 多重共線性への対処:予測変数間の高い相関は、変数の有意性を歪める可能性があります。分散膨張係数(VIF)を使用して多重共線性を確認し、相関の高い変数を削除または結合することを検討してください。
library(car)
vif(logistic_model)
3. データ変換:予測変数と対数オッズ間の非線形関係は、多項式項や相互作用効果などの変換によって捉えることができます。
logistic_model <- glm(Outcome ~ poly(Predictor1, 2) + Predictor2 + Predictor1:Predictor2, family = binomial, data = my_data)
モデル評価手法
1. クロスバリデーション:k分割交差検証を実施して、未知のデータに対するモデルの予測性能を評価します。これにより、過学習を軽減できます。
library(caret)
control <- trainControl(method = "cv", number = 10)
cv_model <- train(Outcome ~ Predictor1 + Predictor2, data = my_data, method = "glm", family = "binomial", trControl = control)
2. モデルのパフォーマンス指標:AIC と逸脱度チェックに加えて、ROC (受信者操作特性) 分析を検討し、AUC (曲線下面積) を計算して、結果クラス間のモデルの識別能力を評価します。
library(pROC)
roc_response <- roc(response = my_data$Outcome, predictor = fitted(logistic_model))
auc(roc_response)
3. 残差分析:モデルの残差を調査し、傾向やクラスターなど、モデルの適合性が低いことを示唆するパターンがないことを確認します。
plot(residuals(logistic_model, type = "deviance"))
ロジスティック回帰モデルを強化するには、特徴量エンジニアリング、体系的なモデル評価、パフォーマンス メトリックに基づく継続的な改良のバランスを慎重に取る必要があります。これらの手法を採用することで、データの複雑さをより適切に捉え、より信頼性の高い予測を提供する、より正確で堅牢な解釈可能なモデルを構築できます。
R を使用したロジスティック回帰の現実世界への応用
ロジスティック回帰は、主に R 環境内で利用される場合、現実世界の幅広いアプリケーションにわたって非常に貴重であることが証明されています。バイナリ結果を処理するその汎用性により、予測分析に基づいて情報に基づいた意思決定を行おうとするさまざまな分野にとって頼りになる方法となっています。ここでは、ロジスティック回帰がうまく適用された実際の例を詳しく掘り下げ、その結果の洞察と意味を明らかにします。
ヘルスケアと医学
医療分野では、患者データに基づいて病気の発生の可能性を予測するためにロジスティック回帰が広く使用されています。たとえば、年齢、BMI、血圧などの患者の属性を分析することで、ロジスティック回帰モデルを使用して糖尿病の発症確率を予測できます。この予測力は、医療専門家が高リスクの患者を特定するのに役立ち、早期介入と管理戦略が可能になります。
# Predicting diabetes occurrence
diabetes_model <- glm(Diabetes ~ Age + BMI + BloodPressure, family = binomial, data = patient_data)
金融
銀行および金融セクターは、ロジスティック回帰を活用して信用リスクを評価します。収入、信用履歴、債務レベルなどの顧客データ ポイントを評価することにより、ロジスティック回帰はローン不履行の確率を予測するのに役立ちます。この洞察は、金融機関が十分な情報に基づいて融資の意思決定を行い、リスクを最小限に抑え、融資承認プロセスを最適化するために非常に重要です。
# Credit risk assessment
credit_risk_model <- glm(Default ~ Income + CreditHistory + DebtLevel, family = binomial, data = customer_data)
マーケティング分析
マーケティングでは、ロジスティック回帰により、製品の購入やキャンペーンへの反応の可能性など、顧客の行動が予測されます。ロジスティック回帰モデルを使用すると、マーケティング担当者は過去の購入データと人口統計情報を分析し、顧客エンゲージメントを強化し、マーケティング戦略を最適化することで、キャンペーンをより効果的に調整できます。
# Predicting customer purchase behavior
purchase_model <- glm(Purchase ~ Age + Gender + PreviousPurchases, family = binomial, data = sales_data)
社会科学
ロジスティック回帰は社会科学研究、特に投票行動分析や社会傾向の理解などの分野でも使用されます。ロジスティック回帰モデルは、年齢、学歴、社会経済的地位などの要因を調べることで、特定の社会的行動の可能性についての洞察を提供し、政策立案や社会学的理解に貢献します。
# Analyzing voting behavior
voting_model <- glm(Voted ~ Age + EducationLevel + SocioEconomicStatus, family = binomial, data = survey_data)
意味と洞察
これらの領域におけるロジスティック回帰の適用の成功は、予測モデリングにおけるロジスティック回帰の重要性を強調しています。予測変数に基づいてバイナリ結果の確率を定量化することで、関係者は証拠に基づいた意思決定を行うことができ、それぞれの分野での効率と有効性が向上します。
さらに、ロジスティック回帰分析からの洞察は、業界全体での事前対策、政策策定、戦略的調整につながる可能性があります。組織や専門家は、主要な予測因子を特定し、それが結果に及ぼす影響を理解することで、的を絞った介入を実施し、前向きな結果を促進し、リスクを軽減できます。
R を使用したロジスティック回帰により、データセット内の複雑な関係をより深く理解できます。さまざまなセクターが予測分析を利用して情報に基づいた意思決定を行えるようにし、データ主導型の取り組みを世界中で推進する上でその貴重な役割を示しています。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
結論
R を使用したロジスティック回帰の包括的な旅の中で、この統計手法のさまざまな分野にわたる多大な影響と汎用性を明らかにしました。ヘルスケアから金融、社会科学に至るまで、ロジスティック回帰は、データ内の隠れたパターンを解明しようとする人々にとっての指標となります。これは、バイナリの結果を正確に予測できる予測レンズを提供します。 R でロジスティック回帰をマスターすると、アナリストや研究者にデータ主導の意思決定のための強力なツールが提供されるだけでなく、予測モデリングの技術と科学に対するより深い理解も促進されます。私たちが基礎的な概念から高度な応用までを横断してきた中で、情報に基づいた戦略や介入を作成する際のロジスティック回帰の価値は十分に明らかになってきました。
おすすめ記事
関連記事でデータ サイエンスの世界をさらに深く探ってみましょう。さらに多くのトピックに取り組んで、分析の専門知識を広げてください。
- ロジスティック回帰 Scikit-Learn: データ サイエンティストのための包括的なガイド
- 一般化線形モデルの分布を理解する
- ロジスティック回帰の仮定とは何ですか?
- 3 種類のロジスティック回帰とは何ですか?
- Scikit-Learn を使用したロジスティック回帰 (話)
- ロジスティック回帰をマスターする (話)
よくある質問(FAQ)
Q1:Rにおけるロジスティック回帰とは何ですか?独立変数に基づいて二値結果を予測するための統計的手法です。
Q2:ロジスティック回帰にRを使う理由は何ですか?Rには、効率的かつ詳細なロジスティック回帰分析を行うためのglm()などの包括的なパッケージが用意されています。
Q3: ロジスティック回帰は線形回帰とどのように異なりますか?連続値を予測する線形回帰とは異なり、ロジスティック回帰は二値の結果(0または1)を予測します。
Q4:Rでロジスティック回帰を実行するための前提条件は何ですか?ロジスティック回帰分析には、Rプログラミングと統計概念に関する基本的な知識が不可欠です。
Q5:Rにおけるロジスティック回帰の出力結果をどのように解釈すればよいですか?出力結果には係数が含まれており、これは各予測変数と結果の対数オッズとの関係を示しています。
Q6:ロジスティック回帰におけるデータ前処理の役割は何ですか?前処理とは、モデルの精度と効率を向上させるためにデータをクリーニングおよび変換することです。
Q7: ロジスティック回帰はカテゴリ変数を扱えますか?ロジスティック回帰は、R のダミーコーディングまたは因子変数を使用してカテゴリ変数を含めることができます。
Q8: R言語でロジスティック回帰モデルの精度を向上させるにはどうすればよいですか?モデルの精度は、特徴選択、多重共線性の処理、および正則化手法の使用によって向上させることができます。
Q9:ロジスティック回帰における一般的な課題にはどのようなものがありますか?課題としては、不均衡なデータセットへの対処、関連性の高い特徴量の選択、モデルの適合性の診断などが挙げられます。
Q10:Rを用いたロジスティック回帰はどのような分野で応用できますか?医学、マーケティング、金融、社会科学などの分野で、二値結果の予測に広く応用されています。