外れ値の検出と処理: 包括的なガイド
外れ値の検出と処理、真実の洞察を得るためにデータを調整するための重要なテクニックを学びます。
イントロダクション
データサイエンスにおいて、外れ値の検出と処理は、の整合性と信頼性を保護する重要なプロセスです。 データ分析の完全性と信頼性を確保するための重要なプロセスです。外れ値(標準から著しく逸脱したデータポイント)は、結果を歪め、誤った結論につながるなど、重大な課題となります。外れ値の検出と処理は、単にデータを精緻化するだけでなく、科学的探求における正確性と真実性という原則を遵守することにもつながります。このガイドは、データサイエンティストが外れ値の複雑な問題に対処するために必要な包括的な知識とツールを提供し、彼らの研究が統計的完全性の最高水準を反映し、この分野の知識の進歩に貢献することを保証することを目的としています。
ハイライト
- 外れ値はデータ分析を大きく歪め、誤解を招く結論につながる可能性があります。
- Z スコアや IQR などの統計手法は、外れ値を検出するための基本です。
- 機械学習アプローチは、複雑なデータセット内の外れ値を特定するための高度なソリューションを提供します。
- 外れ値を適切に処理すると、モデルの精度と予測パフォーマンスが大幅に向上します。
- 異常値の処理における倫理的配慮は、データ サイエンスの完全性を強調します。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
外れ値を理解する
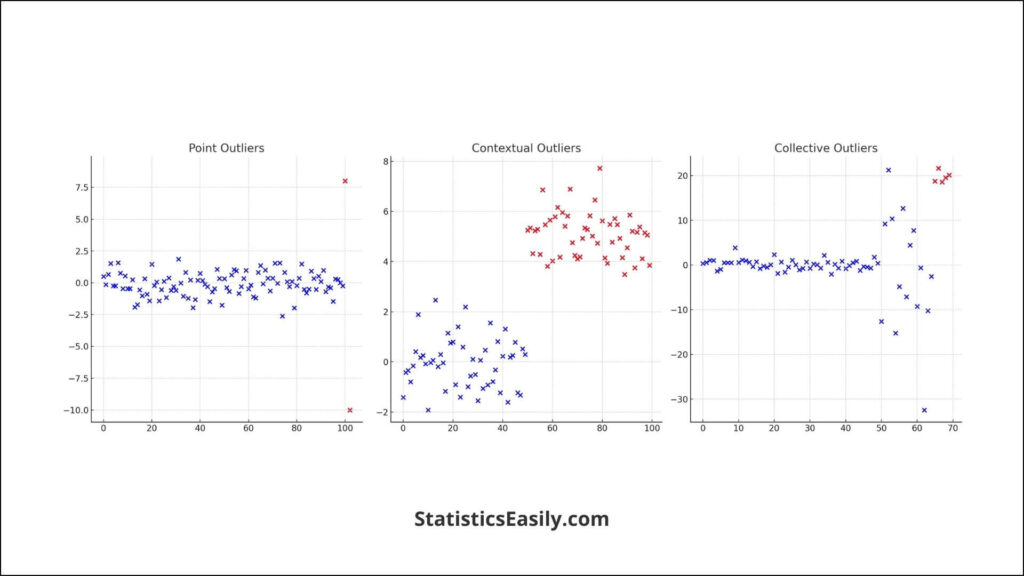
データサイエンスにおいて、外れ値はデータセット全体のパターンから大きく外れたデータポイントのことです。これらの異常値は分析全体に大きな影響を与え、結果の偏りや誤解を招く可能性のある結論につながることがあります。外れ値には主に3つの種類があります。1つ目は、他のデータから大きく離れた単一のデータポイントである点外れ文脈的外れ値です。2つ目は、特定の状況下で異常とみなされるデータポイントである文脈外れ値です。3つ目は、データセット全体と比較して、データポイントの集合が異常である集合外れ値です。全体のデータセットに比べてデータポイントのコレクションが珍しい場合。
外れ値分析の理論的基礎は、データ分析の整合性を維持する上で外れ値の検出と処理が重要な役割を果たすことを強調しています。外れ値は平均値や標準偏差などの統計的尺度を歪め、データ分析の結果に影響を与える可能性があります。たとえば、単一の外れ値によって平均が大きく変動する可能性があり、データの傾向や動作について誤った結論につながる可能性があります。
これらの外れ値を理解して特定することは、堅牢なデータ分析プロセスにとって非常に重要です。外れ値を認識して適切に対処することで、データ サイエンティストは、データ分析から得られた結論が正確であり、基礎となるデータの本質を反映していることを確認できます。このステップは、単なるデータのクレンジングではなく、データが表現しようとしているものの本質を保存し、それによって科学プロセスにおける真実と完全性の原則を遵守することを目的としています。
外れ値の原因
データセットにおける外れ値は、さまざまな原因から発生する可能性があり、正確なデータ分析のためには、それぞれを慎重に検討する必要があります。測定誤差はよくある原因で、測定機器の誤差や人的ミスによって、真の値から大きくかけ離れたデータポイントが生じます。データ入力エラーも重要な原因の一つで、多くの場合、タイプミスや単位の誤解釈によって、異常に高い値や低い値が入力されます。さらに、データの自然な変動性も外れ値を生み出す可能性があり、特に複雑なシステムでは、予期せぬ極端な値が発生することがあります。
特定の化学物質濃度を測定する科学実験の場合を考えてみましょう。分光計が故障すると、異常に高い濃度、つまり測定誤差に起因する外れ値が報告される可能性があります。別のシナリオでは、余分な桁が誤って測定値に追加されたときに、データ入力エラーによって外れ値が発生する可能性があります。最後に、人間の身長を記録するデータセットでは、非常に背の高い個人が自然のばらつきを表しており、真実で集団の多様性を反映している外れ値が導入されています。
これらの例は、外れ値の性質を識別することの重要性を強調しています。本能的にそれらを除去したいと思うかもしれませんが、その原因を理解することでより深い洞察が得られる可能性があります。たとえば、化学物質濃度データの異常値は機器のチェックを促し、将来の精度を確保します。身長データセット内の異常に背の高い個人は、身長に影響を与える遺伝的要因を研究している研究者にとって興味深いかもしれません。
したがって、異常値の除去は反射的なプロセスではなく、コンテキストと原因を考慮した思慮深いプロセスである必要があります。このアプローチにより、データ分析が真実に基づいたものとなり、根底にある現実を正確に反映し、科学的調査における完全性と徹底性の原則が具体化されることが保証されます。
検出技術
外れ値の検出はデータ分析において不可欠なステップであり、統計モデルの精度と信頼性を確保します。これらの異常を効果的に特定するために、さまざまな方法が開発されています。
統計的手法:
Zスコアは、外れ値を検出する最も一般的な方法の一つです。この手法では、データポイントが平均値からどれだけ標準偏差分だけ離れているかを測定します。一般的に、Zスコアが±3を超えるデータポイントは外れ値とみなされます。
四分位範囲(IQR)とは、データの第1四分位数(25パーセンタイル)と第3四分位数(75パーセンタイル)の範囲を計算することです。外れ値は、第1四分位数より1.5倍低い、または第3四分位数より1.5倍高いデータポイントとして特定されます。
グラブス検定(最大正規化残差検定)は、データセット内の単一の外れ値を検出する検定です。この検定は正規分布を前提としており、外れ値が1つだけ疑われる場合に最適です。
機械学習のアプローチ:
機械学習は大規模データセットの外れ値を特定するための高度な技術を提供します。アルゴリズムは、機械学習は、大規模データセットにおける外れ値を特定するための高度な技術を提供します。アイソレーションフォレストとDBSCAN(ノイズを含むアプリケーションの密度ベース空間クラスタリング)などのアルゴリズムは、データの分布と密度を考慮することで、異常値を検出するのに特に効果的です。
ケーススタディ:
外れ値検出の注目すべき応用例の一つは、不正検出です。金融機関は機械学習モデルを用いて、顧客の支出パターンから大きく逸脱し、不正行為を示唆する可能性のある異常な取引を特定します。
において医療分野では、外れ値検出法は治療に対する異常な反応を監視するために用いられる。例えば、臨床試験において薬剤に対する予期せぬ副作用が発生した場合、それは外れ値とみなされ、さらなる調査が必要であることを示唆する。
の分野環境科学の分野も、外れ値検出の恩恵を受けている。研究者は、気温や降水量の急激な上昇など、気候データにおける異常な変化を特定し調査することで、気候変動のダイナミクスをより深く理解することができる。
治療と対処戦略
外れ値の特定はデータ分析の最初のステップにすぎません。これらの外れ値をどのように扱い、処理するかは、研究の結果と完全性に大きく影響する重要な決定です。外れ値を処理するための戦略には、除去、変換、代入が含まれ、それぞれに適用のコンテキストと影響が含まれます。
削除は最も単純な方法ですが、慎重に行う必要があります。データポイントを削除すると、貴重な情報が失われたり、結果に偏りが生じたりする可能性があります。この方法は一般的に、明らかなエラーがある場合、または外れ値の影響がその関連性に比べて著しく大きい場合にのみ使用されます。
変換は、外れ値によって生じる歪みを軽減するために数学的な関数を適用することです。一般的な変換には、対数変換、平方根変換、逆数変換などがあります。この方法を用いることでデータ分布を正規化し、データポイントを直接削除することなく、より効果的な分析が可能になります。
補完外れ値を推定値で置き換える手法であり、通常は中央値、平均値、または回帰分析によって行われます。この手法は、データポイントに誤りがあると考えられるものの、対処すべき根本的な傾向を示している場合に有効です。
倫理的配慮:
異常値の処理における意思決定の整合性はバランスが取れている必要があります。それぞれの戦略にはそれぞれの立場がありますが、その選択は倫理的かつ科学的に正当化される必要があります。不便だからという理由でデータポイントを削除することは、データの性質を理解せずに無差別に変換または代入することと同様に、真実の追求に挑戦します。倫理的実践には、外れ値がどのように扱われるかについての透明性と、分析の結論に対する潜在的な影響の認識が必要です。
たとえば、環境科学で原因を調査せずに汚染データから異常値を除去すると、重大な生態学的脅威が隠蔽される可能性があります。同様に、医療における治療に対する異常値の患者の反応から、副作用や新しい治療経路に関する重要な洞察が明らかになる可能性があります。
最終的に、外れ値の処理と処理は、よりクリーンなデータやより快適な分析経路を目指すだけでなく、データ内の根底にある真実を明らかにして理解するという取り組みを反映する必要があります。この取り組みにより、私たちの仕事は、私たちが理解しようとしている現象を誠実に尊重して知識を前進させることができます。
外れ値検出のためのツールとソフトウェア
異常値を特定して管理するデータ サイエンティストにとって、さまざまなツールやソフトウェアが不可欠な協力者として登場しました。これらのツールは、高度なアルゴリズムとユーザーフレンドリーなインターフェイスを備えており、外れ値検出の精度を高め、治療プロセスを合理化し、それによって真実の科学的追求を支えます。
Python ライブラリ:
- Scikit-learn: 包括的な機械学習機能で知られる scikit-learn は、Isolation Forest や Local Outlier Factor (LOF) などの外れ値検出のための実用的な方法を提供します。その多用途性と統合の容易さにより、データ サイエンティストのツールキットの定番となっています。
- PyOD: 外れ値検出に特化したライブラリである PyOD には、ABOD (角度ベースの外れ値検出) などの古典的なアプローチから現代のニューラル ネットワーク ベースのモデルまで、幅広い検出アルゴリズムが含まれています。 PyOD の一貫した API と scikit-learn との統合により、シームレスな分析エクスペリエンスが促進されます。
R パッケージ:
- 外れ値の検出: このパッケージは、単変量データおよび多変量データの外れ値を検出して処理するツールを提供します。特に、堅牢な統計手法とさまざまなデータ型への適応性が高く評価されています。
- mvoutlier: 多変量データに特化した mvoutlier は、外れ値を特定するためのグラフィカルおよび統計的手法を提供します。これは、外れ値が明らかになるまでに時間がかかる複雑なデータセットにとって不可欠なツールです。
ソフトウェアプラットフォーム:
- 騎士:外れ値検出などの高度なデータ分析ワークフローを可能にするグラフィカル ユーザー インターフェイス ベースのソフトウェア。そのモジュール構造には、古典的な統計手法と高度な機械学習アルゴリズムが組み込まれています。
- タブロー: データ視覚化の優れた機能で知られる Tableau には、主に視覚的な分析を通じて外れ値を検出する機能も含まれています。この機能により、ユーザーはグラフィック表現の逸脱を観察することで、大規模なデータセット内の異常を迅速に特定できます。
—
予測モデリングと機械学習における外れ値の役割
外れ値は予測モデリングと機械学習において微妙な位置を占めており、モデルの精度と予測パフォーマンスに大きな影響を与えます。それらの役割を理解することは、それらが表すデータの真実に基づいて堅牢で調整されたモデルを開発するために重要です。
モデルの精度とパフォーマンスへの影響
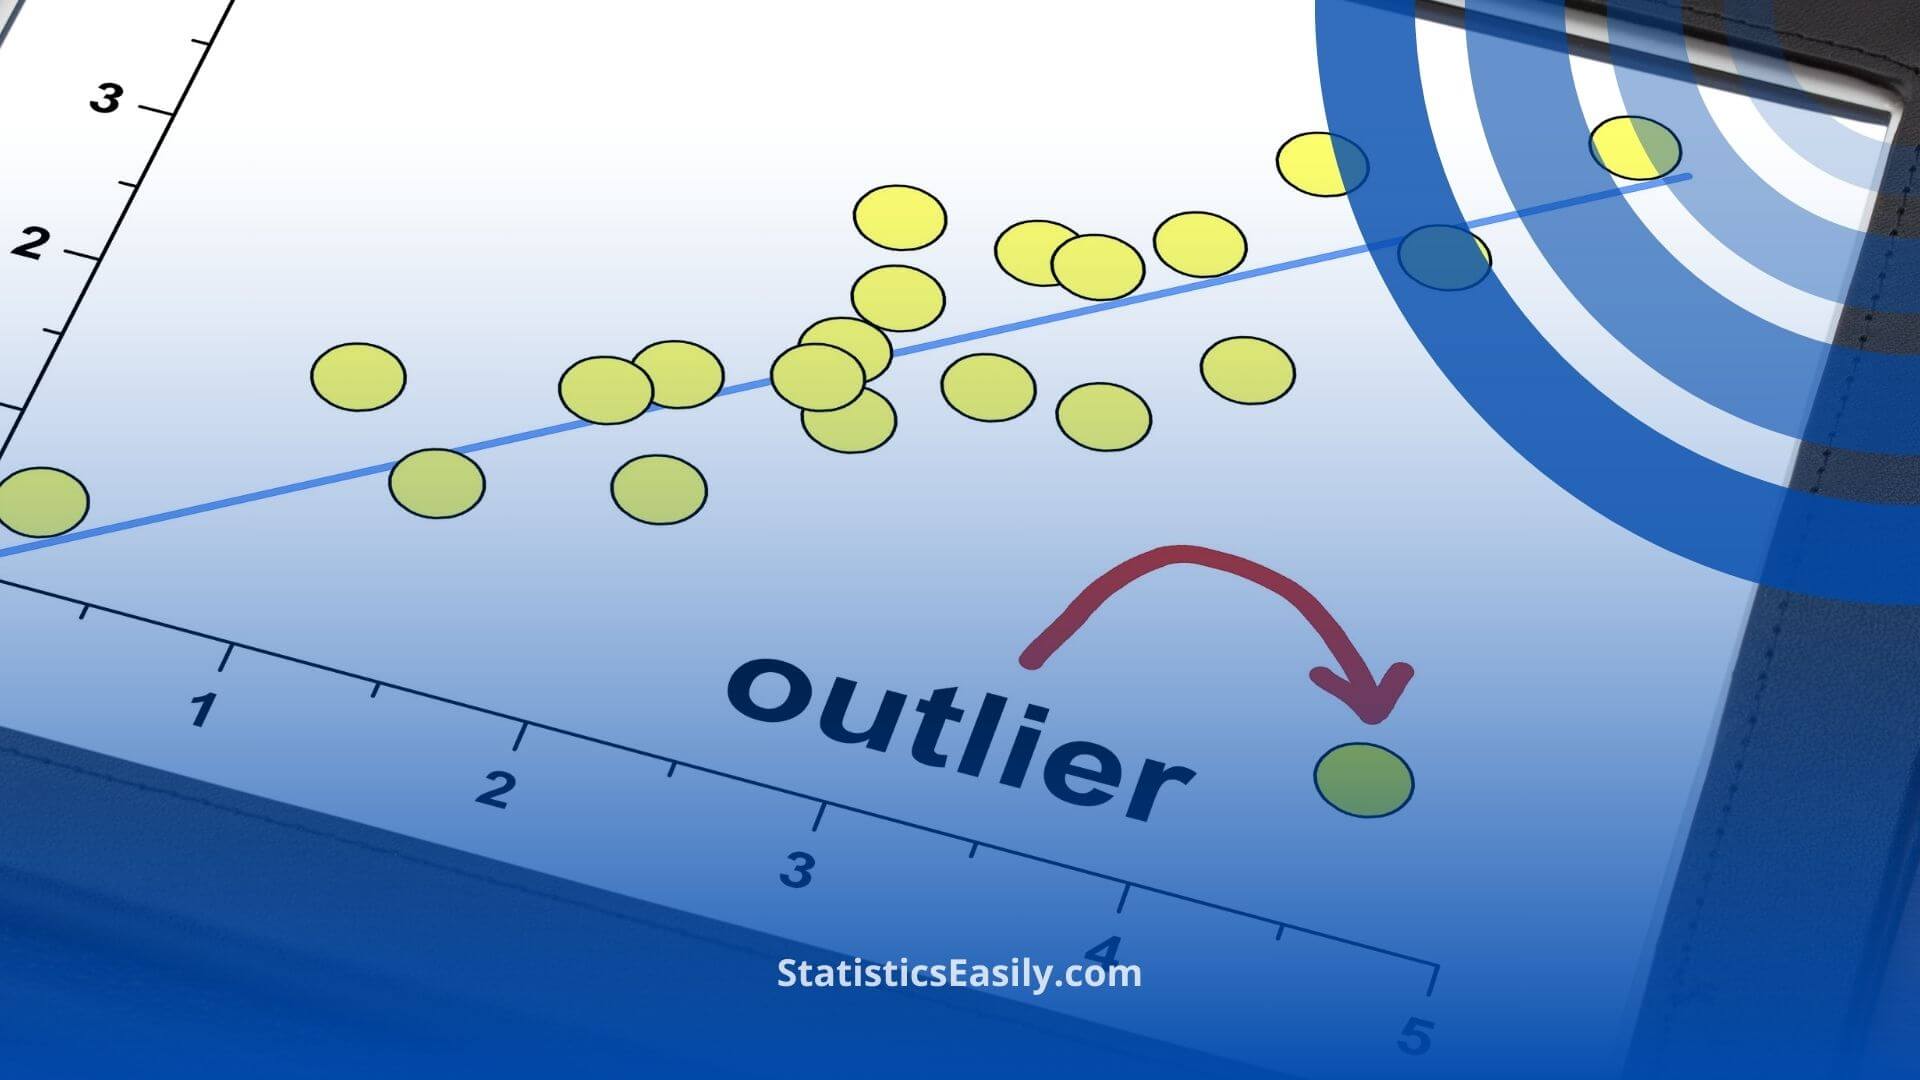
外れ値は、予測モデルのトレーニング プロセスに劇的な影響を与える可能性があります。たとえば、外れ値によって線形回帰モデルの回帰直線が歪められ、一般的なデータセットでのモデルのパフォーマンスが低下する可能性があります。クラスタリング アルゴリズムでは、外れ値によってクラスターの中心が変更され、データ ポイントを正確にグループ化するモデルの能力に影響を与える可能性があります。
モデルトレーニングでの外れ値の処理
外れ値を処理するアプローチは、モデルのトレーニング中に慎重に検討する必要があります。オプションには次のものが含まれます。
- 除外: トレーニング前にデータセットから外れ値を削除します。これは、外れ値が根本的な重要性のない確認されたエラーである場合に適切です。
- 変換: 数学的変換を適用してデータ ポイントの範囲を縮小すると、外れ値が目立たなくなり、完全に削除しなくてもモデルの堅牢性が向上する可能性があります。
- 堅牢なメソッド: ランダム フォレストや堅牢な回帰手法など、外れ値の影響をあまり受けないように設計されたモデルとアルゴリズムを利用します。
モデルが堅牢で真実であることを保証する
モデル トレーニングの整合性は、ノイズの除去と貴重なデータの保存のバランスをとることにあります。本物の変動に関連する異常値は、急いで削除するのではなく、それらが提供する洞察を得るために理解する必要があります。この理解により、より正確で、根底にある現象の複雑さと真実をより反映したモデルが得られます。
外れ値の処理に関するガイダンス
- 分析と文書化: 外れ値を徹底的に分析してその原因を特定し、その処理に関して行われた決定を文書化します。
- 検証: 相互検証手法を使用して、モデルが目に見えないデータに対して適切に機能すること、および外れ値処理戦略によりモデルの一般化可能性が向上することを確認します。
- 継続的モニタリング: 導入後もモデルを継続的に監視して、新しいデータが導入されたときにモデルの有効性が維持されていることを確認する必要があります。新しいデータには有益な外れ値が含まれている可能性があります。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
結論
外れ値の検出と処理を行う過程はデータ サイエンスの鍵であり、データ分析の整合性と信頼性を確保します。これは、データ サイエンティストが科学的取り組みにおいて正確性を達成し、真実を維持することに献身的に取り組んでいることの証です。これまで調査してきたように、外れ値を慎重に特定、分析、処理すると、データが洗練されるだけでなく、理解が深まり、他の方法では不明瞭なままだった洞察が明らかになります。この包括的なガイドは、技術的知識と倫理的配慮のバランスをとって外れ値にアプローチし、データの真実を明らかにするというより優れた追求に私たちの実践を合わせる必要性を強調しています。このガイドを参考にして、知識の継続的な探求と外れ値の扱いにおける倫理原則の適用を促し、科学コミュニティにおける誠実さと徹底の文化を育んでください。
おすすめ記事
分析力を磨く方法について詳しく調べてください。高度なデータ サイエンス技術に関する関連記事を読んで、今すぐ知識を高めてください。
- 一般化線形モデルの基礎を理解する: 包括的な入門
- 精度、精度、再現率、または F1: どの指標が優先されますか?
- 右に歪んだヒストグラム: 非対称データ (話)
- 対応のある t 検定をマスターする (話)
- 対応のある t 検定の例
よくある質問(FAQ)
Q1:データ分析における外れ値とは具体的に何ですか?外れ値とは、他の観測値と著しく異なるデータポイントのことで、統計分析や結果を歪める可能性があります。
Q2:外れ値の検出と処理が重要な理由は何ですか?外れ値を特定して処理することは、正確なデータ分析を行い、モデルが真の根本的なパターンを反映するようにするために不可欠です。
Q3:外れ値は貴重なデータポイントとみなされることはありますか?外れ値は新たな知見やデータ収集におけるエラーを明らかにする可能性があり、その解釈には慎重な分析が必要となる場合が多いです。
Q4:外れ値を検出するための標準的な方法は何ですか?Zスコアと四分位範囲(IQR)は、よく用いられる統計的手法です。
Q5:機械学習モデルは外れ値をどのように処理しますか?アルゴリズムによっては、機械学習モデルは外れ値の影響を最小限に抑えるために前処理が必要な場合もあれば、外れ値に本質的に対応できる場合もあります。
Q6:外れ値は予測モデリングにどのような影響を与えますか?外れ値を適切に処理しないと、モデルの予測が歪められ、精度が低下したり、偏った結果になったりする可能性があります。
Q7:外れ値検出のための自動化ツールはありますか?データセット内の外れ値を検出および処理するために特別に設計されたソフトウェアツールやパッケージがいくつかあります。
Q8:外れ値の処理方法はデータタイプによってどのように異なりますか?処理戦略は、データの性質や分析目標に応じて、 データ変換除去または補完、データの性質と分析目標に応じて。
Q9:外れ値の取り扱いにおいて、どのような倫理的考慮事項が生じますか?倫理的考慮事項には、データの完全性を確保すること、および結果や結論に偏りをもたらす可能性のある操作を避けることが含まれます。
Q10:外れ値の検出と処理に関する知識を深めるにはどうすればよいですか?高度なデータサイエンスコース、チュートリアル、実践的なプロジェクトに取り組むことで、外れ値分析に関する理解とスキルを深めることができます。