ランダム フォレストの実践: 必須ガイド
ランダム フォレストがデシジョン ツリーを活用して複雑なデータセットの予測精度を向上させる方法を学びます。
イントロダクション
ランダムフォレストは、分類タスクと回帰タスクの処理に効果的であることから、データサイエンス分野で広く普及している重要な機械学習アルゴリズムです。その成功の核心は、トレーニングプロセス中に複数の決定木を構築し、個々の決定木についてクラスの最頻値(分類)または平均予測値(回帰)を出力する能力にあります。この入門ガイドは、ランダムフォレストの仕組みを明確なステップバイステップの説明と、 Pythonでの実装方法を実践的に解説することで、初心者にも理解しやすいように構成されています。私たちの目標は、読者がランダムフォレストの理論的基盤を理解し、Pythonの強力なプログラミング機能を活用して、データサイエンスプロジェクトに効果的に適用できるようになるための知識を提供することです。
ハイライト
- ランダム フォレストは、過剰適合を軽減することで単一デシジョン ツリーよりも優れたパフォーマンスを発揮します。
- ランダム フォレストのハイパーパラメータ調整により、モデルの精度が大幅に向上します。
- データの前処理は、ランダム フォレストの予測の成功にとって極めて重要です。
- ステップバイステップの Python ガイドは、ランダム フォレストの実装を簡素化します。
- ランダム フォレスト モデルの評価には、精度、精度、再現率のメトリクスが含まれます。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
ランダムフォレストを理解する
ランダムフォレストは、決定木の概念に基づいて、より正確で堅牢な予測モデルを提供する機械学習アルゴリズムです。学習中に多数の決定木を作成し、個々の決定木について、クラス(分類の場合はクラスの最頻値)、または平均予測値(回帰の場合は平均予測値)を出力します。
ランダム フォレストの仕組み:
決定木:ランダムフォレストは、単純なツリー状の意思決定モデルである決定木から始まります。ランダムフォレストの各ツリーは予測を行い、アルゴリズムは多数決、または回帰の場合は平均値を最終出力として採用します。
ブートストラップ法:この手法では、各ツリーに対してデータセットのサブセットをランダムに選択することで、ツリー間の多様性を確保し、モデルの堅牢性を高めます。
集約(バギング):アルゴリズムは、個々のツリーの予測を集約して、より正確で安定した予測を生成します。
ランダムフォレストの利点:
過学習の軽減:個々の決定木は訓練データへの過学習を起こしやすいのに対し、ランダムフォレストはアンサンブル学習によってこのリスクを軽減します。多数の決定木による予測を平均化することで、モデル全体の予測が訓練データの特定の部分に過度に依存することがなくなり、より汎用性の高い結果が得られます。
高精度:ランダムフォレストの強みは、同じデータの異なるサブセットでそれぞれ学習された複数の決定木からの予測を集約することにあります。このアンサンブル手法は予測精度を大幅に向上させ、様々なデータセットや問題タイプにおいて、多くの単一モデルアプローチを凌駕します。
応用範囲の広さ:ランダムフォレストは、その設計により、分類問題におけるカテゴリカルな結果の予測から、回帰分析における連続変数の推定まで、さまざまなタスクで優れた性能を発揮します。欠損値を含むデータセットを堅牢に処理できる能力と、大掛かりな前処理なしで数値データとカテゴリカルデータを処理できる能力により、非常に柔軟性に優れています。
特徴量の重要性に関する洞察:ランダムフォレストの際立った機能の一つは、その固有の特徴量選択メカニズムです。ランダムフォレストは、すべてのツリーにおける各特徴量が予測精度に与える影響を分析することで、データセット内の特徴量の重要度をランク付けできます。この洞察は、予測の背後にある要因を理解する上で非常に貴重です。モデルの改良や データ分析 プロセスにおける特徴量選択の指針となります。
ランダムフォレストのアプリケーション:
ファイナンス:ランダムフォレストは、金融セクターにおいて、信用スコアの分析による信用リスクの評価や株式市場の将来の動向予測など、重要なタスクに広く利用されており、投資戦略の策定を支援しています。
Eコマース:このアルゴリズムは、ユーザーの行動や好みに基づいて商品を提案するレコメンデーションシステムを支えることで、オンラインショッピング体験を向上させます。また、ターゲットを絞ったマーケティングやプロモーション戦略のために、顧客を明確なグループに分類する上でも重要な役割を果たします。
ヘルスケア分野:ランダムフォレストは、特定の疾患を示唆する症状を患者データから分析することで、早期発見に貢献します。また、患者をリスクグループに分類し、個別化された治療計画の策定にも役立ちます。
サイバーセキュリティ:サイバー脅威の高度化が進む中、ランダムフォレストは、データパターンの異常検出を活用してデジタル資産を保護し、潜在的な不正行為やセキュリティ侵害をタイムリーに検出・予測するのに役立ちます。
ランダムフォレストの理論的基礎
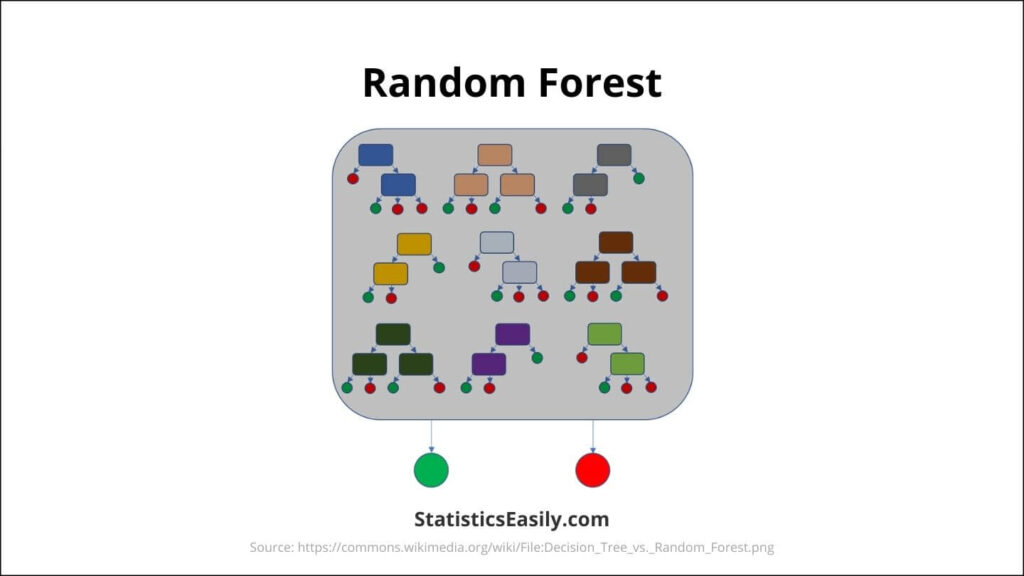
ランダムフォレストアルゴリズムは、アンサンブル学習の原理に基づいて動作します。この原理では、複数の分類器(この場合は決定木)を組み合わせて複雑な問題を解決し、モデルのパフォーマンスを向上させます。
アルゴリズムの詳細な説明:
決定木のアンサンブル:ランダムフォレストは、ブートストラップ法を用いて、トレーニングデータのランダムなサブセットでそれぞれトレーニングされた、相関性のない決定木のフォレストを作成します。
ランダム特徴選択:各ツリーは、分割のたびにランダムな特徴サブセットを選択します。このランダム性によりツリーの多様性が高まり、モデル全体の精度が向上します。
集約:ランダムフォレストの最終的な予測は、個々のツリーの予測を集約することによって決定されます。この集約により、分散が低減され、過学習が抑制され、モデルの予測精度が向上します。
ハイパーパラメータとその影響:
ツリーの数(n_estimators):ツリーの数を増やすと、一般的にモデルのパフォーマンスは向上しますが、計算コストも増加します。
最大深度 (max_depth):各ツリーの深度を制御します。ツリーが深いほど複雑なパターンを捉えることができますが、過学習につながる可能性があります。
最小サンプル分割数 (min_samples_split): 内部ノードを分割するために必要な最小サンプル数を決定します。値が大きいほど、モデルが特定のパターンを学習しすぎるのを防ぎます。
最大特徴量 (max_features): ノードを分割する際に考慮する特徴量のランダムなサブセットのサイズ。これは、フォレスト内のツリーの多様性に影響します。
効果の測定:
精度:全観測値に対する正しく予測された観測値の割合。バランスのとれた分類問題において重要な指標となる。
混同行列:真陽性、真陰性、偽陽性、偽陰性など、モデルのパフォーマンスを詳細に分析したものです。
精度、再現率、F1スコア:精度は、正しく予測された陽性観測値と、予測された陽性観測値の総数との比率です。再現率(感度)は、正しく予測された陽性観測値と、実際のクラスにおけるすべての観測値との比率です。F1スコアは、精度と再現率の加重平均です。これらの指標は、データセットが不均衡な場合に特に重要です。
データの準備
効果的なデータの前処理は、ランダム フォレストのようなモデルのパフォーマンスに大きな影響を与える機械学習における重要なステップです。このセクションでは、データがランダム フォレスト モデリングに最適に構造化されていることを確認する、重要なデータ クリーニングと準備の手順について概説します。
データの前処理の重要性:
データの前処理は、生データを機械学習モデルに直接使用できるクリーンなデータセットに変換します。このプロセスはモデルの学習能力と正確な予測に直接影響するため、非常に重要です。複数のデシジョン ツリーが関与するランダム フォレストの場合、前処理によりデータセット全体の一貫性と品質が保証され、アルゴリズムがより効果的にパターンを識別できるようになります。
データのクリーニングと準備の手順:
1. 欠損値の処理:ランダムフォレストはある程度欠損値を処理できます。しかし、一般的には、数値特徴量の場合は平均値による補完、カテゴリ特徴量の場合は最頻値による補完といった手法を用いて欠損値を補完するのが最善の方法です。
2. カテゴリ変数のエンコード:ランダムフォレストは生のテキストデータを処理できないため、ワンホットエンコーディングやラベルエンコーディングなどのエンコード技術を使用してカテゴリ変数を数値形式に変換します。
3. 特徴量のスケーリング:ランダムフォレストはSVMやKNNのようなアルゴリズムほど特徴量のスケーリングに敏感ではありませんが、すべての特徴量が同じスケールになるようにすることで、モデルの収束と特徴量の重要度スコアの解釈性を向上させることができます。
4. 不要な特徴量の削除:予測に寄与しない、またはノイズの原因となる可能性のある特徴量を削除します。ランダムフォレストはトレーニング中にランダムに特徴量を選択しますが、事前に次元数を削減することで、トレーニング時間と複雑さを軽減できます。
データセットの分割:
トレーニングセットとテストセット:モデルが未知のデータに対してどの程度性能を発揮するかを評価するために、データをトレーニングセットとテストセットに分割します。一般的な分割比率は70:30または80:20で、より多くのデータをトレーニングに使用します。
交差検証:モデルのパフォーマンスがデータの異なるサブセット間で一貫していることを確認するために、交差検証手法、特にk分割交差検証の使用を検討してください。
Pythonによるランダムフォレストの実用化
のランダムフォレストを適用するPythonでランダムフォレストを効果的に適用するには、アルゴリズムの理論的理解と実践的なコーディングスキルを組み合わせる必要があります。このセクションでは、Python環境のセットアップ、sklearnライブラリを使用したランダムフォレストの実装、そして実際のデータセットへの適用について解説します。
実用的な例: アヤメの種の予測
アヤメのデータセットには、がく片の長さ、がく片の幅、花弁の長さ、花弁の幅という 150 つの特徴に基づいて XNUMX つの種に分類された XNUMX のアヤメ植物が含まれています。ランダム フォレスト モデルはトレーニング データから学習し、アヤメ植物の種類を正確に予測します。
以下の手順に従って、Iris データセットだけでなく、さまざまなデータセットに対して Python でランダム フォレストを実装できます。 n_estimators や max_ Depth などのモデルのハイパーパラメータを調整して、特定のデータセットとタスクに基づいてパフォーマンスを向上させます。
提供されるコード スニペットは、理解と実装を容易にするために各ステップの説明があり、簡単に理解できるように設計されています。この実際的なアプリケーションは、予測モデリングにおけるランダム フォレストの力を実証します。より複雑なデータ サイエンス プロジェクトを検討するための強固な基盤を提供します。
Python 環境のセットアップ
Python でランダム フォレストを使用するには、マシンに Python がインストールされていることを確認してください。次のパッケージを使用します。
- NumPy: 配列と行列を処理します。
- パンダ: データの操作と分析用。
- Scikit-Learn (スクラーン): ランダム フォレスト アルゴリズムと、予測モデルを構築するための追加機能を提供します。
- Matplotlib/Seaborn: データとモデルの結果を視覚化します。
pip を使用してこれらのパッケージをインストールします。
pip install numpy pandas scikit-learn matplotlib seaborn
sklearn を使用したランダム フォレストの実装
sklearn.ensemble モジュールには、分類タスク用の RandomForestClassifier と回帰タスク用の RandomForestRegressor が含まれています。 RandomForestClassifier を使用するためのステップバイステップのガイドは次のとおりです。
1. 必要なライブラリをインポートします。
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. データセットを読み込む:この例では、機械学習の例としてよく使われる Iris データセットを使用します。
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. データセットを分割する:モデルのパフォーマンスを評価するために、データをトレーニングセットとテストセットに分割します。
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. モデルの初期化とトレーニング:RandomForestClassifier のインスタンスを作成し、トレーニングデータに適合させます。
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. 予測を行い、モデルを評価する:訓練済みのモデルを使用してテストセットを予測し、精度を評価します。
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
モデルの結果と解釈
モデルをトレーニングして予測を行った後、結果を解釈してそのパフォーマンスと改善方法を理解することが重要です。
モデル性能の評価:まず、モデルの精度を検証し、次に、より詳細な指標を検討します。
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
混同行列:混同行列は、各クラスの正解予測と不正解予測に関する洞察を提供します。
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
分類レポート:分類レポートには、各クラスの精度、再現率、F1スコアなどの指標が含まれます。
print(classification_report(y_test, y_pred, target_names=iris.target_names))
特徴量の重要度:モデルの判断に最も大きな影響を与える特徴量を理解することで、データセットに関する洞察を得ることができます。
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
モデルの解釈
精度スコア、混同行列、分類レポートを総合すると、モデルのパフォーマンスの包括的なビューが提供されます。精度の高さは、アヤメの種の分類におけるモデルの有効性を示しており、混同行列と分類レポートでは、クラス全体の精度、再現率、および f1 スコアが詳細に示されています。
特徴重要度プロットは、アヤメの花のどの特性 (花びらの長さや幅など) がモデルの分類決定に影響を与えるかを明らかにします。この洞察は、ランダム フォレスト モデルの意思決定プロセスと、将来の特徴エンジニアリングや選択の取り組みを理解するのに役立ちます。
これらの結果を解釈すると、ランダム フォレスト分類器はこのデータセットに対して非常に効果的であり、予測モデリング タスクに強固な基盤を提供すると結論付けることができます。さまざまなデータセットを試したり、ハイパーパラメーターを調整したりすると、モデルのパフォーマンスやさまざまな問題への適応性が向上する可能性があります。
ランダム フォレスト内の個々の決定木の解釈
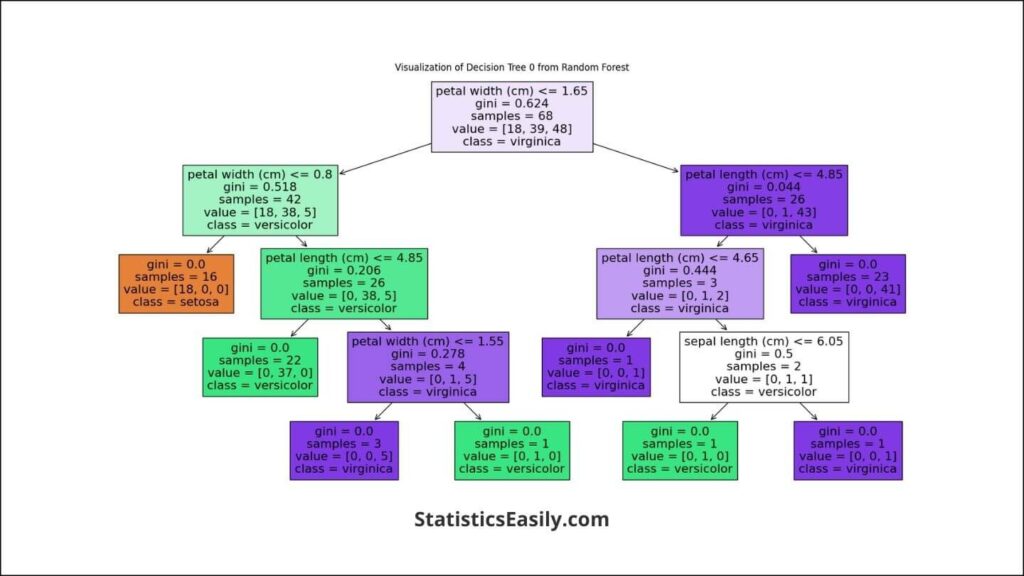
ランダム フォレストは決定ツリーのコレクションですが、各ツリーが結果に寄与します。個々のツリーを視覚化すると、より詳細なレベルでの意思決定プロセスについての洞察が得られます。ランダム フォレスト モデルからそのようなツリーの 1 つを調べてみましょう。
ランダム フォレストからのデシジョン ツリーの視覚化:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
この視覚化は、ランダム フォレスト内の単一のデシジョン ツリーがどのように分類を行うかを示しています。最上位のルート ノードから始まり、特徴値に基づいて分岐と決定ノードに分割され、最後にクラス予測を表すリーフ ノードで終わります。
ツリー構造の分析:
ツリー内の各ノードは、特定の機能の値に基づいた決定を表します。たとえば、ノードはアイリスの花の花びらの長さまたは幅に基づいてデータを分割する場合があります。枝はその決定の結果を表し、新しい決定ノードまたはリーフ ノードにつながります。リーフ ノードは、ルートからのパスによって決定される一連の基準が満たされた場合に、最終的なクラス予測を提供します。
このツリーの深さと複雑さは、モデルの分類戦略を示します。実際には、ランダム フォレストは、そのような複数のツリーからの予測を組み合わせて最終的なより正確な分類を行い、それによって各ツリーの弱点を補いながら長所を活用します。
上記で生成されたようなデシジョン ツリーの視覚化を含めると、読者が予測プロセスを視覚化できるようになり、記事が充実します。これはモデルの動作をわかりやすく説明し、ランダム フォレストが複数の意思決定パスを活用して分類の決定に至る方法の具体的な例を示します。
モデルの評価
Python を使用してランダム フォレスト モデルを実装したら、次の重要なステップはそのパフォーマンスを評価することです。これには、特定のメトリクスを使用して、モデルが新しい未知のデータの結果をどの程度正確に予測するかを理解することが含まれます。このセクションでは、重要な評価指標について説明し、モデルの改善と調整のヒントを提供します。
ランダム フォレスト モデルのパフォーマンスを評価する方法:
評価指標は、ランダム フォレスト モデルの精度と有効性を評価するために不可欠です。最も一般的に使用されるメトリクスは次のとおりです。
精度:これは最も単純な指標で、正解した予測数を予測総数で割って算出されます。精度は有用ですが、特にクラスの不均衡があるデータセットでは、精度だけでは誤解を招く可能性があります。
精度と再現率:精度(すべての陽性予測における真陽性結果の割合)と再現率(すべての実際の陽性における真陽性結果の割合)は、医療診断や不正検出のシナリオなど、偽陽性や偽陰性のコストが高い場合に重要になります。
F1スコア:F1スコアは、精度と再現率の調和平均であり、両者のバランスを評価するための単一の指標です。F1スコアは、1(精度と再現率が完璧)で最高値となり、0で最低値となります。
混同行列:真の値が既知のテストデータセットにおける分類モデルの性能を示す表。真陽性、偽陽性、真陰性、偽陰性など、モデルの予測結果を視覚化できる。
結果の解釈:
これらのメトリクスを理解すると、モデルのパフォーマンスを正確に測定できるようになります。たとえば、正解率が高いと、一見すると優れているように見えるかもしれません。ただし、精度、再現率、F1 スコアをさらに調査すると、特定のクラスを正確に予測できないなど、モデルが問題を抱えている領域が明らかになる可能性があります。
モデルの改善とチューニングのヒント:
ハイパーパラメータ調整:ランダムフォレストモデルには、ツリーの数(n_estimators)やツリーの深さ(max_depth)など、パフォーマンスに大きな影響を与えるハイパーパラメータがいくつかあります。グリッドサーチやランダムサーチなどの手法を用いることで、特定のデータセットに最適なハイパーパラメータの組み合わせを見つけることができます。
特徴選択:ランダムフォレストは、特徴量の重要度を本質的にランク付けすることができます。重要度の低い特徴量を分析して削除することで、モデルの複雑さを軽減し、パフォーマンスを向上させることができます。
交差検証:k分割交差検証などの交差検証を実装することで、データセットの異なるサブセット間でモデルのパフォーマンスが一貫していることを保証し、モデルの堅牢性を高めることができます。
広告タイトル
広告の説明。 Lorem ipsum dolor sit amet, consectetur adipiscing elit.
結論
この記事では、Python のランダム フォレストを理解して適用するための包括的なガイドを提供し、その理論的基礎、データの準備、実際の実装、モデルの評価をカバーしました。分類と回帰のタスクを効果的に処理できる機能を備えたランダム フォレストは、データ サイエンティストにとって依然として強力なツールであり、過剰適合に対する高い精度と堅牢性を提供します。さまざまなデータセットを試し、さまざまな予測モデリングの問題に対処することを奨励することで、ランダム フォレストの多用途性と適応性が強調されます。 Python 環境のセットアップからモデルのパフォーマンスの評価まで、詳細な手順に従うことで、読者はデータ サイエンス プロジェクトでランダム フォレストを活用し、予測分析の限界を押し上げるための準備が整います。
おすすめ記事
他の記事をチェックして、データ サイエンスのトピックに関するさらなる洞察とチュートリアルを探索してください。
- デシジョン ツリー: 意欲的なデータ サイエンティストのための Python の理論から実践まで
- ランダム サンプリングについて: データ分析の重要なテクニック
- Excel でのランダム サンプリング: 徹底した分析
- Scikit-Learn を使用したロジスティック回帰 (話)
- 乱数を生成する
よくある質問(FAQ)
Q1:ランダムフォレストとは何ですか?ランダムフォレストは、複数の決定木を使用し、それらの予測を平均化することで精度を向上させ、過学習を抑制する、回帰と分類タスクを実行できる汎用性の高い機械学習手法です。
Q2:ランダムフォレストはどのように機能しますか?ランダムフォレストは、ランダムな決定木の「森」を作成し、結果を平均化したり多数決を使用したりすることで、単一の決定木よりも予測精度を高めます。
Q3:ランダムフォレストが他のアルゴリズムよりも好まれる理由は何ですか? ランダムフォレストは汎用性が高く、高次元の大規模データセットを処理でき、欠損値を適切に処理できるため、過学習に強いという利点があります。
Q4:ランダムフォレストの主な用途は何ですか?銀行、医療、株式市場、電子商取引など、さまざまな分野で、不正検出、疾病予測、株価予測、顧客セグメンテーションなどに幅広く使用されています。
Q5:ランダムフォレストのためのデータ準備はどのように行いますか?データ準備には、データのクリーニング、欠損値の処理、カテゴリ変数のエンコード、データセットをトレーニングセットとテストセットに分割することが含まれます。
Q6: ランダムフォレストにおけるハイパーパラメータとは何ですか?また、それらはモデルにどのような影響を与えますか?ハイパーパラメータは、ツリーの数、ツリーの深さ、最小サンプル分割数など、モデルの複雑さとパフォーマンスに影響を与えます。これらを調整することで、精度を大幅に向上させることができます。
Q7:ランダムフォレストモデルの有効性をどのように評価できますか?標準的な評価指標には、精度、適合率、再現率、F1スコア、混同行列などがあり、これらはモデルの予測性能と精度を評価するのに役立ちます。
Q8:ランダムフォレストを使用する際の課題は何ですか?ランダムフォレストは強力ですが、より単純なモデルと比較して計算負荷が高く、解釈が難しい場合があり、ノイズの多いデータに対してパフォーマンスが影響を受けやすい場合があります。
Q9: ランダムフォレストモデルのパフォーマンスを向上させるには、どのように調整すればよいですか?モデルの調整には、グリッドサーチやランダムサーチなどの手法を用いて、ツリーの数、最大深度、最小サンプル数といったハイパーパラメータを調整し、最適な設定を見つけることが含まれます。
Q10:ランダムフォレストはカテゴリデータと数値データの両方を処理できますか?はい、ランダムフォレストはカテゴリデータと数値データが混在したデータを処理できます。カテゴリ変数にはワンホットエンコーディングなどの手法を用いて、モデリングに適したデータ形式に変換します。